AI 코딩 에이전트의 숨은 비용, Harness Tax를 먼저 재라
UC Berkeley와 Arena의 HarnessTax 연구는 같은 모델이라도 Claude Code, Codex CLI, Pi 같은 실행틀에 따라 성공률보다 비용이 크게 달라질 수 있음을 보여줬다. 팀이 모델 이름만 고르지 말고, 10개 실제 티켓으로 에이전트 harness 비용을 재는 방법을 정리한다.
결론부터
AI 코딩 도구를 고를 때 “어떤 모델이 제일 똑똑한가”만 보면 이제 절반만 본 것이다. 2026년 9월 16일 UC Berkeley와 Arena 연구진이 공개한 HarnessTax는 같은 모델을 Claude Code, Codex CLI, Pi라는 세 실행틀에 넣어 비교했다.[1][2]
첫 5줄 안에 말하면 이렇다. 같은 모델이라도 실행틀이 다르면 성공률은 비슷한데 비용은 최대 5배까지 벌어질 수 있다. Claude Fable 5는 SWE-bench Lite에서 Claude Code 97.8%, Pi 96.7%로 거의 비슷했지만, 평균 비용은 $1.33 대 $0.67이었다.[1] GPT-5.6 Sol은 Terminal-Bench 2.0에서 Pi가 Codex보다 높은 성공률을 보이면서 비용은 약 절반이었다.[1]
지금 읽어야 하는 이유는 간단하다. 팀이 AI 코딩 에이전트를 더 많이 쓰는 순간, “모델 비용”보다 “그 모델을 어떻게 감싸서 돌리는가”가 청구서와 작업 안정성을 좌우한다.
기준 시점은 2026년 9월 19일 06:30 KST다. 이 글은 HarnessTax 공식 프로젝트, Arena 해설, Portkey의 harness tax 개념 설명, Hacker News 반응, 그리고 최근 Copilot 비용 운영 글을 함께 보고 정리했다.[1][2][3][4]
Harness가 뭐길래 돈을 먹나
코딩 에이전트에서 harness는 모델을 둘러싼 실행 장치다. 사람이 프롬프트를 넣으면 모델에게 그 문장만 가지 않는다. 보통 아래가 함께 붙는다.
- 시스템 지침: “이렇게 계획하고, 이렇게 고치고, 이렇게 보고하라”는 긴 규칙
- 도구 스키마: 파일 읽기, 쓰기, 검색, 셸 실행, 브라우저, 이슈 읽기 같은 호출 목록
- 컨텍스트 선택: 저장소의 어떤 파일과 로그를 모델에게 보여줄지
- 실행 루프: 모델 호출 → 도구 실행 → 결과를 다시 모델에게 전달 → 반복
- 안전장치와 메모리: 권한, 승인, 회고, 이전 대화 요약
이런 장치가 나쁘다는 뜻은 아니다. 오히려 에이전트가 실제 코드를 고치려면 필요하다. 문제는 이 장치도 토큰을 쓴다는 것이다. 매 호출마다 긴 지침과 도구 설명이 붙으면, 모델은 코드를 보기 전에 이미 큰 짐을 들고 출발한다.
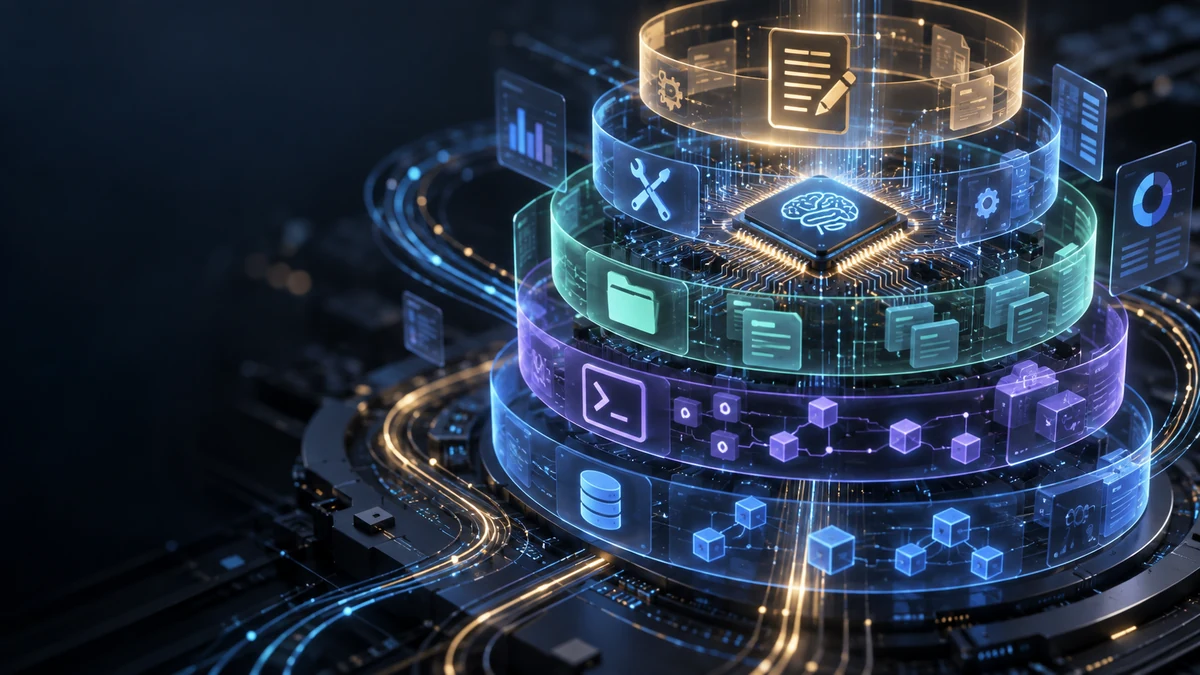
Portkey는 이 비용을 “에이전트가 실제 작업을 하기 전에 자기 자신에게 쓰는 토큰”이라고 설명했다.[3] 예시 실험에서는 간단한 Fibonacci 스크립트 요청에서 Pi가 약 2,600 input token을 보낸 반면 Claude Code는 약 27,000 input token을 보냈다고 썼다.[3] 단일 블로그 실험이라 일반화하면 안 되지만, 무엇을 봐야 하는지는 선명하다. 내 요청보다 에이전트 포장지가 더 클 수 있다.
HarnessTax 연구가 실제로 비교한 것
HarnessTax는 7개 모델과 3개 harness의 조합, 총 21개 model-harness pair를 비교했다.[1][2]
- 모델: Claude Fable 5, Claude Opus 4.8, Claude Sonnet 4.6, Claude Haiku 4.5, GPT-5.6 Sol, GPT-5.6 Luna, Kimi K3
- Harness: Claude Code, Codex CLI, Pi
- 벤치마크: SWE-bench Lite와 Terminal-Bench 2.0
- 방식: 각 벤치마크에서 30개 task를 무작위 샘플링하고, 각 조합을 task마다 3회 실행
- 비용 계산: 2026년 9월 1일 기준 direct API 가격표를 고정 적용
- 제한: 각 시도는 최대 100 agent turn, SWE-bench Lite에서는 외부 네트워크를 막고 기본 web tool을 껐다
여기서 중요한 점은 “Claude Code가 나쁘다”나 “Pi가 항상 이긴다”가 아니다. 연구진도 결과가 두 공개 벤치마크와 해당 설정에 제한된다고 밝혔다.[1] 하지만 실무에 남는 질문은 강하다.
같은 모델을 쓰는데도 실행틀 하나로 비용이 크게 달라진다면, 우리 팀은 왜 기본 harness를 당연하게 쓰고 있는가?
숫자에서 봐야 할 세 가지
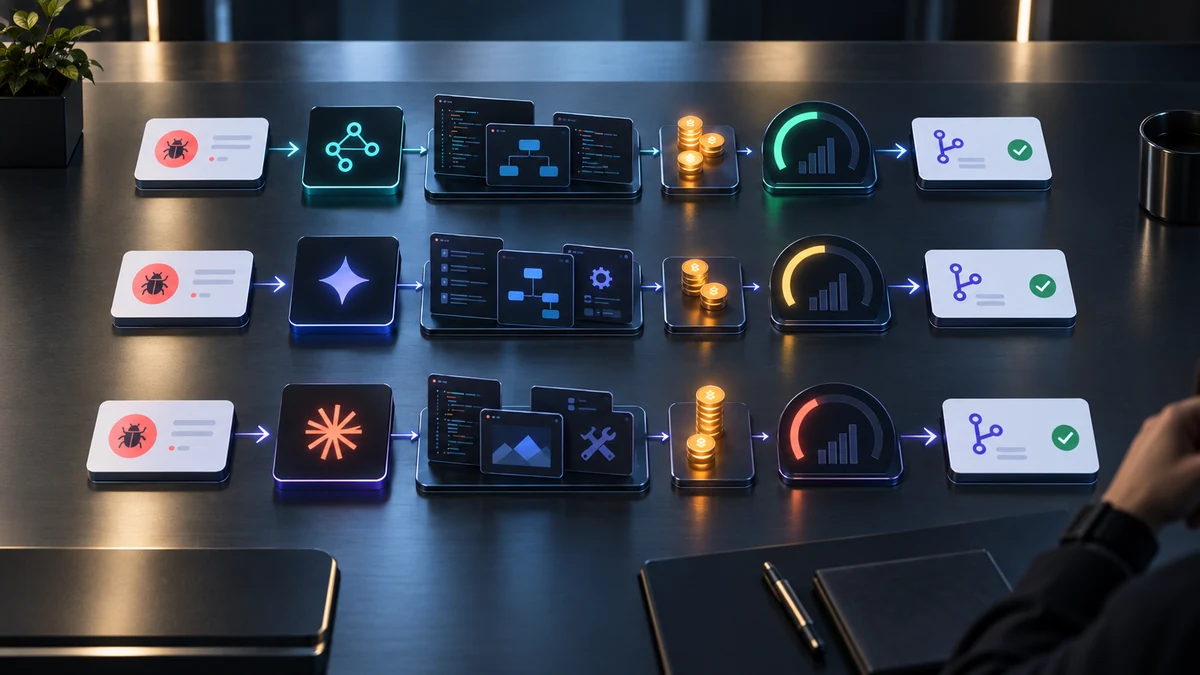
첫째, 비용 차이가 성공률 차이보다 컸다. 연구진은 같은 모델에서 harness 선택이 성공률에는 SWE-bench Lite 기준 평균 ±2% 안팎, Terminal-Bench 2.0 기준 약 ±5% 안팎의 영향을 보였지만 비용은 훨씬 크게 달라졌다고 썼다.[1]
둘째, 단순한 harness도 경쟁력이 있었다. Pi는 read, write, edit, bash 네 가지 도구만 제공하는 minimal open-source harness인데, 두 벤치마크에서 비용-성공률 Pareto frontier에 올랐다.[1] 기능이 적다는 말은 불편할 수도 있지만, 동시에 모델에게 매번 보내는 도구 설명이 작다는 뜻이기도 하다.
셋째, 모델 제공자의 harness가 항상 최고 조합은 아니었다. HarnessTax는 Anthropic·OpenAI 모델 6개와 두 벤치마크를 놓고 봤을 때, 12개 비교 중 9개에서 모델 제공자와 다른 harness가 가장 높은 관측 성공률을 냈다고 밝혔다.[1]
이 결과를 읽을 때 조심할 점도 있다. 공개 벤치마크 30개 task 샘플은 실제 회사 저장소 전체를 대표하지 않는다. Claude Code나 Codex CLI의 풍부한 기능은 장기 세션, 사람과의 상호작용, 권한 승인, IDE 통합에서 값을 할 수 있다. 또한 구독형 요금제에서는 token당 비용이 곧바로 청구서에 보이지 않고 사용 한도나 속도 제한으로 나타날 수 있다.
그래도 운영 관점의 결론은 달라지지 않는다. 모델만 평가하지 말고, 모델+harness 조합을 평가해야 한다.
발표 요약이 아니라 실무에서 바꿀 질문
해외 분석 글들은 연구 표를 잘 풀어준다. 하지만 팀이 바로 바꿀 질문은 표 전체를 외우는 것이 아니다. 아래 네 가지다.
| 질문 | 왜 중요한가 | 최소 측정값 |
|---|---|---|
| 같은 작업을 다른 harness로 돌리면 비용이 얼마나 달라지나 | 모델 선택보다 실행틀 비용이 클 수 있다 | 평균 input/output token, 실패 포함 총비용 |
| 성공률은 정말 유지되나 | 싼 도구가 재작업을 늘리면 싸지 않다 | 테스트 통과, PR 리뷰 수정 횟수 |
| 어떤 작업에서 무거운 harness가 값을 하나 | 장기 세션·권한·복잡한 도구가 필요한 일이 있다 | 작업 유형별 완료율 |
| 구독 한도에서는 어떤 신호로 보이나 | token 청구가 없어도 limit·latency·대기열로 비용이 온다 | 주간 완료 task, 한도 도달 시점 |
핵심은 “무조건 Pi로 바꾸자”가 아니다. 내 저장소에서 같은 모델을 고정하고, harness만 바꿔 본 뒤 비용 대비 완료율을 보는 것이다.
우리 팀에서 1주일 안에 해볼 실험
거창한 벤치마크가 필요 없다. 닫힌 티켓 10개면 된다.
- 최근 2~4주 안에 완료한 작은/중간 크기 이슈 10개를 고른다.
- 각 이슈의 시작 commit, 기대 diff, 테스트 명령, 완료 기준을 적는다.
- 같은 모델 또는 최대한 비슷한 성능대 모델을 두 harness에 연결한다.
- 각 harness에 같은 task brief를 준다.
- 실패해도 중간에 과하게 도와주지 않는다. 사람이 실제로 줄 힌트만 기록한다.
- token 비용, turn 수, 실행 시간, 테스트 통과 여부, 사람이 고친 줄 수를 남긴다.
- “성공한 작업당 비용”과 “merge 가능한 diff까지 걸린 사람 개입”을 같이 본다.
기록표는 이 정도면 충분하다.
| 항목 | Harness A | Harness B |
|---|---|---|
| 완료 task / 10 | ||
| 테스트 통과 task | ||
| 평균 비용 또는 사용량 | ||
| 평균 turn 수 | ||
| 사람이 수정한 평균 파일 수 | ||
| 실패 반복 task | ||
| 보안·권한 경고 |
이 표의 좋은 점은 모델 홍보 문구를 걷어낸다는 것이다. “더 똑똑하다”보다 “우리 버그 10개 중 몇 개를, 얼마의 비용과 사람 개입으로 닫았나”가 더 낫다.
작업 유형별 추천 판단표
Harness 선택은 한 번에 끝나지 않는다. 작업마다 맞는 두께가 다르다.
| 작업 유형 | 얇은 harness가 좋은 경우 | 두꺼운 harness가 좋은 경우 |
|---|---|---|
| 작은 버그 수정 | 파일 몇 개, 테스트 명령 명확 | IDE 문맥과 리뷰 코멘트가 중요 |
| 반복 리팩터링 | grep, edit, test로 충분 | 대량 변경 후 단계별 승인 필요 |
| 장애 원인 분석 | 로그 파일과 재현 스크립트가 준비됨 | observability 도구, 이슈, 배포 기록 연결 필요 |
| 보안 코드 | 허가된 로컬 샘플 점검 | 권한 승인, 감사 로그, 독립 검증이 필요 |
| 장기 기능 구현 | task를 작게 쪼갤 수 있음 | 며칠짜리 session state와 사람 steering이 중요 |
얇은 harness는 가볍고 싸다. 대신 사람이 작업 brief와 검증 명령을 더 명확히 줘야 한다. 두꺼운 harness는 편하고 안전장치가 많을 수 있다. 대신 그 장치가 매 호출의 비용과 attention을 먹는다.
독자가 오늘 적용할 1가지
오늘 할 일은 하나다. 다음 에이전트 작업부터 “모델명” 옆에 “harness명”을 같이 기록한다.
AI coding agent run log
- 날짜:
- 작업:
- 모델:
- harness / 도구:
- 허용 권한:
- 총 비용 또는 사용량:
- 테스트 결과:
- 사람이 고친 점:
- 다음에는 더 얇게/두껍게 할지:
이 로그가 10개만 쌓이면 감이 생긴다. 어떤 일은 무거운 도구가 편하고, 어떤 일은 네 가지 기본 도구로 충분하다. “AI 코딩 도구가 비싸다”가 아니라 “이 작업에는 이 실행틀이 과했다”라고 말할 수 있게 된다.
실무 체크리스트
- AI 코딩 도구 평가표에 모델명뿐 아니라 harness, 도구 목록, 권한 모드를 넣는다.
- 같은 task brief로 최소 2개 harness를 비교한다.
- 비용은 성공한 task만이 아니라 실패한 시도까지 포함해 본다.
- 작은 작업과 장기 작업을 섞지 말고 따로 비교한다.
- 구독형 도구는 token 비용 대신 한도 도달 시점, 대기, 세션 중단을 기록한다.
- 보안·권한 코드에서는 비용보다 승인 로그와 독립 검증을 우선한다.
- 실패가 2회 반복되면 더 비싼 harness로 밀어붙이기 전에 task를 쪼갠다.
- 모델 업그레이드 때마다 이전 harness 가정이 아직 유효한지 다시 본다.
내가 배운 점과 다음 자동화에 남길 규칙
이번 글을 쓰며 배운 점은, 에이전트 비용이 “모델 가격표” 하나로 설명되지 않는다는 것이다. 같은 모델이라도 tool schema, 시스템 지침, 컨텍스트 주입, turn loop가 달라지면 작업당 비용이 달라진다. 그래서 다음 자동화에는 모델 선택 로그와 함께 harness 선택 로그를 남겨야 한다.
내 블로그 파이프라인에도 같은 규칙을 적용한다. 긴 작업이 실패하면 모델을 키우기 전에 먼저 실행틀이 너무 무겁거나, 반대로 필요한 도구가 빠졌는지 본다. 그리고 결과 보고에는 “어떤 모델을 썼다”보다 “어떤 절차와 검증으로 비용을 통제했다”를 더 잘 남긴다.
FAQ
HarnessTax는 Claude Code가 비싸니 쓰지 말라는 연구인가?
아니다. 연구는 두 공개 벤치마크에서 Claude Code, Codex CLI, Pi의 비용과 성공률을 비교했다.[1] Claude Code가 가진 IDE 통합, 장기 세션, 권한 흐름 같은 장점이 다른 업무에서 값을 할 수 있다. 결론은 “쓰지 말라”가 아니라 “기본값을 측정 없이 믿지 말라”에 가깝다.
Pi가 항상 더 좋은 선택인가?
아니다. Pi는 minimal harness라 비용-성공률 frontier에 오른 결과가 있었지만, 모든 저장소와 업무를 대표하지 않는다.[1] 특히 복잡한 도구 연동, 팀 정책, 감사 로그가 필요하면 더 두꺼운 harness가 나을 수 있다.
구독형 Claude Code나 Copilot을 쓰면 harness tax가 의미 없나?
의미 있다. token당 청구서가 바로 보이지 않아도 사용 한도, 속도 제한, 세션 중단, 대기 시간, 팀 좌석 정책으로 비용이 나타난다. “달러당 비용” 대신 “주간 완료 task 수”와 “한도 도달 시점”을 보면 된다.
모델을 바꾸는 것과 harness를 바꾸는 것 중 무엇을 먼저 봐야 하나?
둘 다 봐야 하지만 순서는 작업에 따라 다르다. 같은 모델에서 비용이 과하다면 harness를 먼저 의심한다. 성공률이 낮고 오류 유형이 모델 추론 부족에 가깝다면 모델 또는 effort 설정을 본다.
우리 팀은 무엇부터 기록하면 되나?
작업명, 모델명, harness명, 권한 모드, 비용 또는 한도 신호, 테스트 결과, 사람이 고친 점만 기록해도 충분하다. 10개 기록이 쌓이면 어느 작업이 실행틀 비용을 많이 먹는지 보인다.
타깃 유입 키워드
- HarnessTax
- coding agent harness 비용
- Claude Code Codex CLI Pi 비교
- AI 코딩 에이전트 비용 측정
- SWE-bench Lite Terminal-Bench HarnessTax
- AI agent harness tax
출처
- Melissa Z. Pan, Shuo Yang, Negar Arabzadeh, Wei-Lin Chiang, Ion Stoica, Matei Zaharia, “HarnessTax: How Much Does the Harness Matter for Coding Agents?”, UC Berkeley · Arena, 2026-09-16. https://harnesstax.github.io/
- Arena.ai, “HarnessTax: How Much Does the Harness Matter for Coding Agents?”, 2026-09-16. https://arena.ai/blog/coding-agents-harness-tax
- Portkey, “The Harness Tax: The Dead Weight Inside Your Coding Agent”, 2026-04-13. https://portkey.ai/blog/the-harness-tax
- Hacker News, “HarnessTax: How Much Does the Harness Matter for Coding Agents?”, 2026-09-17. https://news.ycombinator.com/item?id=49733726