OpenAI Agents API를 보며 배운 것: 에이전트는 모델보다 실행틀이 먼저다
OpenAI가 Codex 뒤의 harness를 Agents API로 공개했다. 이제 에이전트 도입 판단은 모델 이름보다 세션, 샌드박스, 툴 검색, 컴팩션, 서브에이전트, 데이터 보존을 어떻게 운영할지에 가까워졌다. 직접 만들 것과 맡길 것을 나누는 체크리스트를 정리한다.
결론부터
OpenAI가 2026년 9월 10일 Agents API를 public beta로 공개했다. 한 줄로 쓰면 “Codex 뒤에서 돌던 에이전트 실행틀을 API로 부를 수 있게 했다”는 소식이다.[1]
지금 읽어야 하는 이유는 새 모델이 하나 더 나왔기 때문이 아니다. 모델을 호출하는 코드는 이미 누구나 짤 수 있다. 어려운 부분은 몇 시간 또는 며칠 걸리는 작업을 세션으로 붙잡고, 파일을 다루고, 도구를 찾고, 중간 맥락을 압축하고, 실패하면 다시 이어가는 부분이다.
그래서 이번 뉴스의 질문은 이렇다.
“어떤 모델을 쓸까?”보다 “에이전트가 일하는 실행틀을 직접 만들까, 맡길까?”가 먼저다.
기준 시점은 2026년 9월 17일이다. 이 글은 OpenAI 공식 발표와 Agents API 문서, GitHub Copilot의 최근 에이전트 운영 흐름, 그리고 GitHub Trending에서 보이는 agent skills·memory·harness 관심을 함께 보고 정리했다.[1][2][3][4][5]
Agents API는 무엇인가
OpenAI Agents API는 모델 하나를 부르는 API라기보다, 에이전트 작업을 담는 실행 레이어다. 공식 발표는 “Codex를 구동하는 harness와 infrastructure”를 개발자에게 제공한다고 설명한다.[1]
여기서 harness는 낯선 말처럼 보이지만, 실제로는 에이전트가 일할 때 필요한 안전벨트와 작업대에 가깝다.
- 세션을 만들고 이어간다.
- 파일을 놓고 코드를 실행할 환경을 붙인다.
- MCP나 함수 같은 도구를 연결한다.
- 필요한 경우 서브에이전트로 일을 나눈다.
- 긴 작업에서 맥락을 압축한다.
- 진행 상황을 이벤트, 스트리밍, 웹훅으로 읽게 한다.
채팅 API만으로도 작은 자동화는 가능하다. 하지만 “이 장애 원인을 30분치 로그와 배포 이력으로 조사하고, 관련 파일을 고치고, 테스트하고, 근거를 남겨라” 같은 작업은 다르다. 모델 답변보다 작업의 생명주기가 길다. 이때 직접 루프를 만들면 금방 아래 문제를 만난다.
긴 에이전트 작업에서 자주 터지는 것
1. 컨텍스트가 길어져 중요한 결정을 잃는다.
2. 도구 설명이 많아져 프롬프트가 비싸진다.
3. 파일과 중간 산출물을 어디에 둘지 애매하다.
4. 실패한 작업을 어디서 이어갈지 모른다.
5. 서브작업을 병렬로 나누면 결과 합치기가 어렵다.
6. 사람이 중간에 끼어들거나 승인해야 하는 지점이 흐려진다.
Agents API는 이 중 상당 부분을 플랫폼 쪽으로 가져간다. 그래서 이번 발표는 “새로운 에이전트 프레임워크가 하나 더 나왔다”보다 “에이전트 프레임워크의 귀찮은 운영부가 플랫폼 기본 기능으로 내려오기 시작했다”에 가깝다.
직접 만드는 것과 맡기는 것을 나눠야 한다
이런 API가 나오면 마음이 급해진다. “이제 우리 자동화도 전부 에이전트로 바꿀 수 있나?” 같은 생각이 먼저 든다. 나는 반대로 보는 편이 낫다고 본다. 먼저 나눠야 한다.
| 영역 | 플랫폼에 맡겨도 되는 것 | 우리가 계속 가져야 하는 것 |
|---|---|---|
| 세션 | 작업 상태 저장, 이벤트 스트림, 이어가기 | 어떤 작업을 세션으로 만들지, 완료 기준은 무엇인지 |
| 실행 환경 | OpenAI hosted sandbox 또는 partner/self-hosted 연결 | 데이터가 어디로 나가도 되는지, 네트워크와 비밀값 경계 |
| 도구 | MCP, 함수, tool search, programmatic tool calling | 도구 설명 품질, 권한, 실패 처리, 감사 로그 |
| 긴 맥락 | compaction, context 관리 | 무엇이 절대 사라지면 안 되는 결정인지 |
| 병렬화 | subagent orchestration | 일을 나누는 기준, 충돌 해결, 최종 책임 |
| 비용 | API 자체 추가 요금 없음, 토큰·도구·컨테이너 과금 | 예산 한도, 재시도 제한, 작업별 ROI |
핵심은 “플랫폼이 해준다”와 “책임이 사라진다”를 구분하는 것이다. 예를 들어 OpenAI 문서는 Agents API가 세션 상태를 유지하고, 필요 없어진 세션과 published artifacts를 삭제할 수 있다고 설명한다.[2] 동시에 현재 Agents API는 데이터 거주지가 미국만 지원되고 Zero Data Retention은 지원하지 않는다고 밝힌다. self-hosted sandbox를 골라도 Agents API 자체가 ZDR eligible이 되는 것은 아니라고 적혀 있다.[2]
이건 작은 문장이지만 도입 판단에서는 큰 문장이다. 코드 실행은 내 VPC에서 하더라도, 세션 상태와 API 레이어의 데이터 보존 조건은 따로 봐야 한다는 뜻이다.
샌드박스 선택은 “편한가”가 아니라 “어디까지 맡길까”다
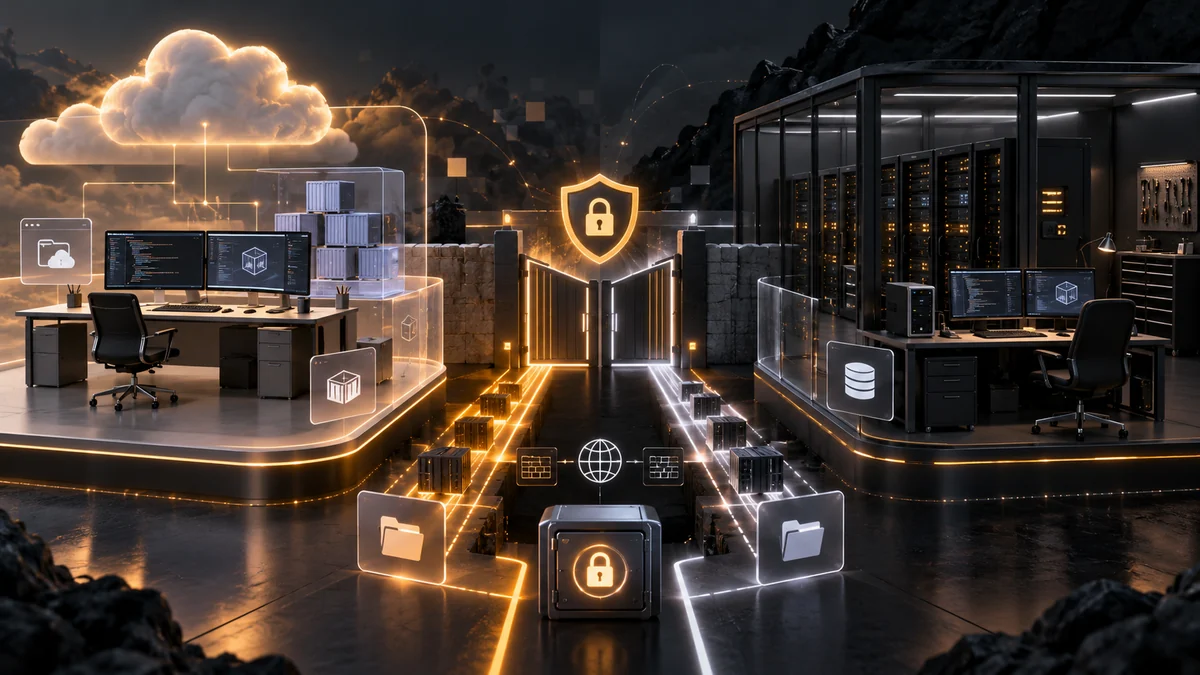
OpenAI 발표는 Agents API에서 실행 환경을 고를 수 있다고 설명한다. OpenAI-hosted sandbox, 자체 인프라, 또는 Cloudflare, E2B, Modal, Vercel 같은 sandbox partner를 선택하는 식이다.[1]
처음 실험은 hosted가 편하다. 환경을 빨리 만들고, 파일을 올리고, 산출물을 받기 쉽다. 하지만 실무에서는 아래 질문이 먼저다.
| 질문 | hosted가 편한 경우 | self-hosted/partner를 봐야 하는 경우 |
|---|---|---|
| 다루는 데이터 | 공개 저장소, 샘플 로그, 비민감 문서 | 고객 로그, 내부 DB, 규제 데이터 |
| 네트워크 | 외부 공식 문서와 패키지 접근 위주 | 사내 API, private subnet, 고정 egress |
| 파일 | 임시 산출물 중심 | 장기 보관, 사내 스토리지, forensic 보존 |
| 비용 | 작은 실험, 낮은 동시성 | 긴 작업, 많은 컨테이너 시간, 예산 상한 필요 |
| 감사 | 간단한 이벤트 확인 | 사내 SIEM, 승인자, 변경 이력 연결 |
에이전트는 사람보다 빨리 움직인다. 그래서 샌드박스는 “모델에게 작업 공간을 준다”가 아니라 “실패해도 피해가 제한되는 방을 만든다”에 가깝다. 이 방이 너무 작으면 쓸모가 없고, 너무 크면 사고가 난다.
Tool search는 사소해 보이지만 비용 구조를 바꾼다
Agents API 문서에서 눈에 띄는 기능 중 하나는 tool search다. 도구가 몇 개 없을 때는 모든 함수 설명을 프롬프트에 넣어도 된다. 하지만 실제 업무 자동화는 금방 달라진다. GitHub, Slack, Notion, 배포, 로그, 검색, DB, 결제, 메일, 캘린더 도구가 붙으면 도구 설명만으로도 프롬프트가 지저분해진다.
OpenAI 문서는 eager loading과 deferred loading을 나눈다. 작은 도구 묶음은 바로 싣고, 큰 카탈로그에서는 defer_loading: true와 tool_search를 써서 필요한 도구만 찾는 전략을 제안한다. 도구 설명을 전부 싣는 방식은 쓰지 않는 정의가 컨텍스트를 차지하고, 정의가 바뀌면 캐시 prefix를 깨뜨릴 수 있다는 tradeoff도 적는다.[4]
이 말은 실제로는 이렇게 들린다.
도구가 많아질수록 “프롬프트 잘 쓰기”가 아니라 “도구 카탈로그를 운영하기”가 된다.
도구 카탈로그에는 최소한 세 가지가 들어가야 한다.
- 이름: 사람이 봐도 기능을 짐작할 수 있어야 한다.
- 설명: 언제 쓰고 언제 쓰면 안 되는지 짧게 써야 한다.
- 권한: 읽기, 쓰기, 외부 전송, 비용 발생 여부가 보여야 한다.
여기서 어제 다룬 권한표가 다시 등장한다. 도구를 잘 찾는 것만으로는 부족하다. 찾아도 되는 도구, 찾았지만 승인받아야 하는 도구, 아예 노출하면 안 되는 도구를 나눠야 한다. GitHub가 최근 Copilot agent operations에 대해 shell, file read/edit, network domain을 block/approval/allow로 중앙 관리하게 한 것도 같은 방향이다.[5]
Compaction은 “요약”이 아니라 운영 이벤트다
긴 에이전트 작업은 언젠가 컨텍스트 한계에 닿는다. 그때 흔한 해결책은 “앞부분을 요약해서 넣자”다. 문제는 무엇을 요약하느냐다. 에이전트 작업에서 사라지면 안 되는 것은 예쁜 문장이 아니라 결정과 증거다.
OpenAI 발표는 Agents API가 세션이 context limit에 가까워질 때 자동 compaction으로 이전 맥락을 보존한다고 설명한다.[1] 별도 compaction 문서도 긴 입력을 compact한 뒤 다음 요청 input으로 이어가는 예시를 보여준다.[3]
실무에서 compaction을 믿으려면 아래 항목이 남아야 한다.
| 반드시 남아야 하는 것 | 예시 |
|---|---|
| 목표 | “/api/hit이 카운터 숨김 상태에서도 실행되어야 한다” |
| 제약 | “src/data/itNews.ts는 이번 작업 범위 밖” |
| 읽은 근거 | 공식 문서 URL, 로그 파일, 테스트 결과 |
| 결정 | “fallback 이미지 금지, ChatGPT 레인만 사용” |
| 변경 파일 | 어떤 파일을 왜 수정했는지 |
| 실패와 재시도 | 어떤 명령이 왜 실패했고 어떻게 우회했는지 |
| 남은 위험 | deploy 후 read-back 필요, 특정 환경변수 미확인 |
내가 가져갈 규칙은 간단하다. compaction을 플랫폼에 맡기더라도, “압축 후에도 남아야 할 불변 조건”은 사람이 적어야 한다. 에이전트에게 “알아서 잘 요약해”라고 맡기는 대신, 작업 시작 시 아래처럼 남기는 방식이다.
이 작업에서 절대 잃으면 안 되는 조건
- 수정 가능 파일 범위:
- 외부 호출 허용 범위:
- 배포/삭제/메일 발송 승인 조건:
- 성공 판정 명령:
- 사용자에게 보고할 증거:
이 다섯 줄만 있어도 긴 작업의 사고 확률이 줄어든다.
Subagent는 속도보다 분리 기준이 중요하다
Agents API는 multi-agent support도 제공한다. 독립적인 작업을 서브에이전트에 나눠 병렬로 처리하고, 메인 에이전트가 결과를 합치는 구조다.[1]
좋아 보인다. 실제로 연구, 로그 분석, 코드베이스 탐색처럼 독립성이 높은 작업은 병렬화 가치가 있다. 다만 subagent를 “많이 띄우면 빨라진다”로만 보면 위험하다. 결과가 서로 충돌하거나, 같은 파일을 다르게 해석하거나, 출처 검증 없이 요약만 늘어날 수 있다.
좋은 분리 기준은 역할이 아니라 산출물이다.
| 나눠도 좋은 작업 | 이유 |
|---|---|
| 공식 문서 사실 확인 | 출처와 문장 단위 결과가 명확하다. |
| 로그 구간별 이상 탐지 | 시간 범위가 분리된다. |
| 후보 주제 조사 | 후보별 점수와 탈락 이유로 합칠 수 있다. |
| 이미지 품질 체크 | 컷별 pass/fail이 분리된다. |
| 코드 변경 전 영향 범위 조사 | 실제 수정 전에 읽기 전용으로 끝낼 수 있다. |
반대로 “이 파일을 고쳐라”를 여러 에이전트에게 동시에 주는 것은 조심해야 한다. 속도보다 merge conflict와 책임 소재가 더 커질 수 있다.
오늘 적용할 1가지
오늘 할 일은 API를 붙이는 것이 아니다. 먼저 “우리 자동화의 harness map”을 그리는 것이다.
아래 표를 복사해 한 작업만 채워보면 된다.
| 항목 | 적을 것 |
|---|---|
| 작업 이름 | 예: 블로그 초안→이미지→검수→배포 |
| 세션 시작 조건 | 언제 새 세션을 만들 것인가 |
| 성공 조건 | 어떤 명령과 read-back이 통과해야 끝인가 |
| 도구 목록 | 파일, 브라우저, 검색, 배포, 업로드, MCP |
| allow/ask/deny | 자동 허용, 사람 승인, 차단 작업 |
| 샌드박스 | hosted로 충분한가, self-hosted가 필요한가 |
| 데이터 보존 | 세션·파일·로그가 어디에 남아도 되는가 |
| compaction 불변 조건 | 절대 사라지면 안 되는 목표와 제약 |
| 비용 제한 | 재시도 횟수, 컨테이너 시간, 이미지 생성 비용 |
| 롤백 | 실패 시 되돌릴 git commit, 배포, 외부 기록 |
이 표를 채우다 보면 “Agents API를 써야겠다”와 “아직 단순 queue + script가 낫다”가 갈린다. 오래 도는 작업, 파일과 도구가 많은 작업, 중간 검증이 중요한 작업이라면 managed harness의 가치가 크다. 반대로 한 번의 API 호출로 끝나는 분류, 요약, 변환 작업이라면 굳이 세션형 에이전트로 만들 필요가 없다.
FAQ
Q. Agents API를 쓰면 기존 에이전트 프레임워크가 필요 없어지나?
아니다. 많은 팀은 여전히 자체 워크플로, 권한 정책, UI, 감사 로그, 평가 시스템이 필요하다. 다만 세션, 샌드박스, compaction, tool orchestration 같은 반복 인프라를 직접 만들 이유는 줄어든다.
Q. self-hosted sandbox를 쓰면 데이터 보존 문제가 사라지나?
사라지지 않는다. OpenAI 문서는 Agents API가 현재 미국 데이터 거주지만 지원하고 ZDR을 지원하지 않으며, self-hosted sandbox를 선택해도 Agents API가 ZDR eligible이 되는 것은 아니라고 설명한다.[2] 실행 환경과 API 레이어의 데이터 보존을 분리해 봐야 한다.
Q. tool search는 언제 필요한가?
도구가 5개 안팎이면 굳이 필요 없을 수 있다. 하지만 도구가 수십 개 이상이고 작업마다 필요한 도구가 달라진다면 deferred loading과 tool search를 검토할 만하다. OpenAI 문서도 큰 카탈로그에서는 필요한 함수만 불러오는 전략을 제안한다.[4]
Q. subagent는 언제 쓰면 좋은가?
읽기 전용 조사, 출처 확인, 로그 구간 분석, 후보 비교처럼 결과를 독립적으로 합칠 수 있을 때 좋다. 같은 파일을 동시에 수정하거나 같은 외부 시스템에 write하는 작업은 먼저 잠금, 승인, merge 기준을 정해야 한다.
Q. 제일 먼저 바꿀 운영 습관은 무엇인가?
에이전트에게 일을 맡길 때 “완료되면 알려줘” 대신 “완료 판정 증거를 남겨줘”라고 쓰는 것이다. 빌드 결과, 테스트 결과, 읽은 URL, 변경 파일, 실패한 시도, 배포 후 read-back URL이 있어야 다음 자동화가 믿을 수 있다.
한 줄 정리
OpenAI Agents API가 보여준 방향은 분명하다. 앞으로 에이전트 경쟁력은 모델 이름만으로 갈리지 않는다. 세션을 잃지 않고, 도구를 낭비하지 않고, 권한을 작게 주고, 실패를 읽을 수 있게 만드는 실행틀이 더 중요해진다.
출처
[1] OpenAI, “Introducing the Agents API”, 2026-09-10.
[2] OpenAI API Docs, “Agents API overview”, 2026-09 기준 확인.
[3] OpenAI API Docs, “Compaction”, 2026-09 기준 확인.
[4] OpenAI API Docs, “Tool search”, 2026-09 기준 확인.
[5] GitHub Changelog, “Enterprise managed permissions for GitHub Copilot agent operations”, 2026-09-09.
[6] GitHub Changelog, “Configure cost and quality in Copilot auto model selection”, 2026-09-14.
[7] GitHub Trending, daily/weekly repositories, 2026-09-17 확인.
타깃 유입 키워드
OpenAI Agents API, Codex harness, AI agent harness, agent sandbox, tool search, context compaction, multi-agent API, OpenAI 에이전트 API, AI 에이전트 운영