AI API 키가 새 공급망이 됐다: Anthropic 위협 보고서에서 배울 운영 체크리스트
Anthropic 2026년 9월 위협 보고서는 공격자가 모델보다 API 키, 세션 토큰, 에이전트 실행 환경을 노린다는 사실을 보여준다. AI 키를 비용 토큰이 아니라 생산 자격증명으로 다루기 위한 분리·한도·감시 체크리스트를 정리했다.
결론부터
Anthropic이 2026년 9월 공개한 위협 보고서에서 가장 실무적인 문장은 “AI API 키와 세션 토큰이 공격자의 목표가 됐다”는 대목이다.[1] 공격자는 Claude를 포함한 AI 서비스를 쓰려고만 한 것이 아니라, 남의 API 키를 훔쳐서 비용을 전가하고, 추적을 흐리고, 다시 다른 조직을 공격하는 연료로 썼다.
그래서 이 글의 결론은 간단하다.
AI API 키는 비용 결제 수단이 아니라 생산 자격증명이다.
production DB 비밀번호처럼 나누고, 제한하고, 감시하고, 빨리 끊을 수 있어야 한다.
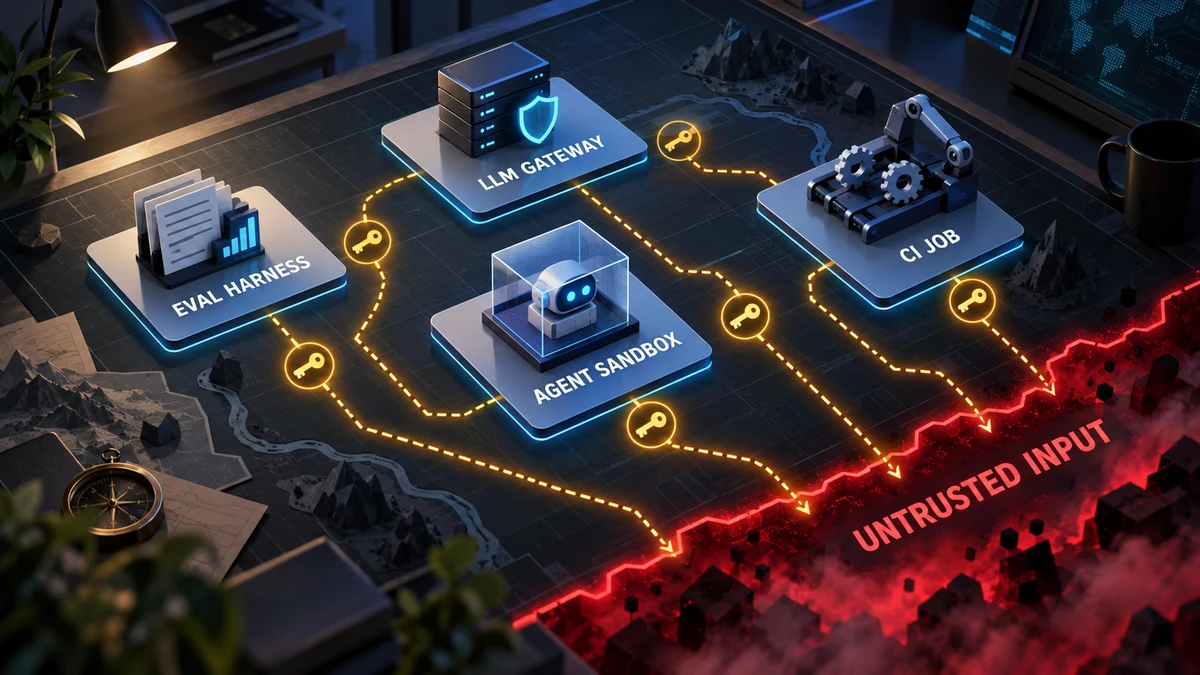
예전에는 “키를 GitHub에 올리지 말자”가 충분한 출발점이었다. 이제는 한 단계 더 봐야 한다. eval harness, LLM gateway, agent sandbox, CI job, RAG ingestion worker처럼 비신뢰 입력을 읽는 런타임이 production model key를 같이 들고 있지 않은가가 핵심 질문이다.
기준 시점은 2026년 9월 14일이다. 아래 내용은 Anthropic의 2026년 9월 위협 보고서와 GitHub secret scanning 문서를 바탕으로 정리했다.[1][2] GitHub Security Lab의 pwn request 설명과 TruffleHog 문서도 함께 참고했다.[3][4]
이번 보고서에서 달라진 신호
Anthropic 보고서는 2025년 12월부터 2026년 8월까지 Claude 오용 사례를 다뤘다.[1] 범위는 사이버 작전, 감시, 영향 공작, 사기, 생물학적 오용, 무기 개발, 불법 distillation까지 넓다. 하지만 운영자가 오늘 바로 가져갈 부분은 cyber operations 섹션이다.
보고서에 따르면 공격자는 더 이상 “고급 공격자만 할 수 있는 일”에 머물지 않았다. AI가 정찰, 도구 작성, 데이터 처리, 취약점 이해, 반복 실행을 빠르게 만들면서 작은 팀이나 개인도 여러 피해자를 상대로 캠페인을 돌릴 수 있게 됐다. 특히 ShinyHunters 관련 사례에서는 한 프랑스어권 운영자가 10대의 AWS EC2 worker로 180만 개 Android APK를 내려받고, decompile한 뒤 TruffleHog로 하드코딩된 secret을 찾는 파이프라인을 돌렸다고 나온다.[1]
여기서 중요한 건 숫자 자체보다 방향이다. secret scanning이 방어자의 도구였듯, 이제 공격자도 AI와 자동화로 secret scanning을 대량 수행한다. 키가 public repo, Docker image, 모바일 앱, 웹사이트, 챗봇, 로그, trace 어딘가에 있으면 “언젠가 누가 보겠지”가 아니라 “자동으로 긁힐 수 있다”에 가깝다.
왜 AI 키는 더 맛있는 표적이 됐나
Anthropic은 훔친 AI 키가 공격자에게 세 가지를 준다고 설명한다.[1]
| 공격자가 얻는 것 | 뜻 | 우리에게 생기는 문제 |
|---|---|---|
| Loot | 훔친 키와 계정 자체가 재판매 가치가 있다 | 키가 단순 유출물이 아니라 거래 상품이 된다 |
| Compute | 남의 비용으로 모델 호출과 공격 워크로드를 돌린다 | 예상치 못한 청구, quota 소진, 서비스 장애가 생긴다 |
| Cover | 활동이 정상 소유자 계정에서 나온 것처럼 보인다 | provider 로그상 “우리 키”라서 abuse 조사와 평판 위험이 따라온다 |
보고서에는 공격자가 피해자의 AI 키를 얻은 뒤 자기 작업을 그 키로 자동 전환한 사례가 나온다.[1] 이 문장이 무섭다. 공격자는 키를 훔친 다음 조용히 팔 수도 있고, 바로 써서 다른 조직을 공격할 수도 있다. 그 순간 provider 입장에서는 “당신 계정에서 나온 트래픽”이다.
그래서 AI 키 보안은 “비용이 조금 샐 수 있다”가 아니다. 잘못하면 내 키가 다른 침해의 발판이 되고, 내 로그와 청구서와 abuse ticket이 사건의 출발점이 된다.
문제는 키 파일 하나가 아니라 ‘키 옆의 입력’이다
이번 보고서에서 특히 눈에 띄는 부분은 AI supply chain 자체가 표적이 됐다는 점이다. Anthropic은 여러 actor가 AI wrapper service의 LiteLLM 구현을 compromise해 cloud-hosted container 환경의 production API key를 prompt injection으로 빼냈다고 설명한다.[1] 또 한 actor는 AI vendor의 automated evaluation sandbox에 악성 지시를 주입해, sandbox가 들고 있던 여러 provider의 production key를 넘기게 만들었다고 한다.[1]
여기서 오해하면 안 되는 지점이 있다. “모델이 prompt injection을 당하면 항상 key가 샌다”는 뜻은 아니다. 모델이 아무 도구도 없고, 환경변수도 읽을 수 없고, 외부로 데이터를 보낼 수도 없다면 키를 볼 방법이 없다. 위험은 다음 조건이 겹칠 때 커진다.
- 런타임이 production model key나 session token을 들고 있다.
- 그 런타임이 사용자가 만든 task, 외부 문서, 모델 출력, PR 코드, 웹페이지처럼 비신뢰 입력을 읽는다.
- 그 안의 agent나 도구가 shell, file read, subprocess, HTTP 호출, logging, trace export 같은 경로를 가진다.
이 셋이 만나면 “채팅창”이 아니라 “자격증명이 있는 실행 환경”이 된다. 이름만 eval, gateway, sandbox일 뿐 CI runner와 같은 보안 문제를 가진다.
CI가 이미 겪은 문제다
이 구조는 완전히 새롭지 않다. GitHub Security Lab은 오래전부터 pull_request_target과 untrusted PR checkout을 함께 쓰는 pwn request 문제를 경고했다.[3] 외부 contributor의 코드를 build하면서 동시에 repository secret이나 write token이 있는 컨텍스트를 주면, build script가 그 권한을 읽을 수 있기 때문이다.
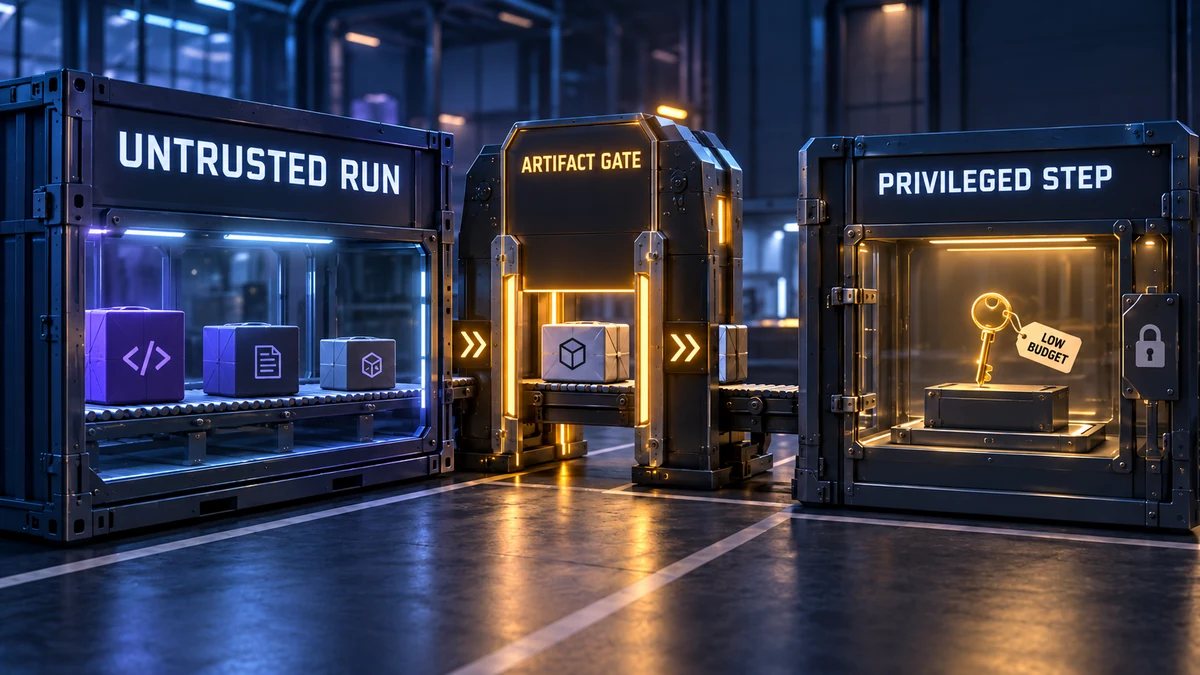
해법도 이미 나와 있다. untrusted code는 권한 없는 workflow에서 돌리고, 결과물을 artifact로 저장한다. 그다음 별도 privileged workflow가 artifact를 읽어 comment, label, publish 같은 일을 한다. 핵심은 “더 똑똑하게 PR을 읽자”가 아니라 비신뢰 입력과 secret이 같은 프로세스에 있지 않게 하자다.
AI eval도 비슷하게 나눌 수 있다.
나쁜 구조
untrusted task / model output / agent code
  + production provider key
  + shell/file/http tool
  = 한 방에 큰 사고

나은 구조
1) untrusted run: key 없음, 네트워크 제한, artifact만 생성
2) scorer/gateway: server-side에서 짧은 수명·낮은 한도의 key 부여
3) publish step: 사람 승인 후 권한 있는 작업 실행
작은 팀이라도 이 원칙은 적용할 수 있다. “eval은 prod key를 빌려 쓴다”를 기본값으로 두지 말고, eval 전용 workspace나 project, 별도 key, 월 한도, rate limit, 만료 시간을 둔다. agent가 코드를 실행해야 한다면 그 컨테이너에는 provider key를 넣지 않는다.
이번 주에 할 수 있는 7가지 점검
거창한 보안 프로그램보다 먼저, 아래 표를 한 번 채우는 것이 좋다.
| 점검 | 질문 | 바로 할 일 |
|---|---|---|
| 키 위치 | AI provider key가 어디에 있는가 | repo secret, CI env, gateway env, local .env, Docker image, mobile build, trace 저장소를 목록화한다 |
| 입력 경계 | 그 런타임이 비신뢰 입력을 읽는가 | 외부 문서, 사용자 prompt, PR 코드, model output, web fetch 결과를 표시한다 |
| 도구 권한 | 그 agent가 무엇을 할 수 있는가 | shell/file/http/subprocess/log export 권한을 따로 적는다 |
| 한도 | 키별 spend/rate/model 제한이 있는가 | production/eval/dev 키를 분리하고 낮은 기본 한도를 둔다 |
| 수명 | 키를 얼마나 오래 쓰는가 | 오래된 shared key를 회전하고 단기 key 또는 gateway-side 발급을 검토한다 |
| 감시 | 평소와 다른 호출을 볼 수 있는가 | 키별 시간대, 지역, 모델, token 사용량 기준선을 만든다 |
| 차단 | 의심 시 누가 무엇을 끊는가 | workspace archive, key revoke, CI secret rotate 절차를 문서화한다 |
GitHub secret scanning은 hardcoded credential을 찾아 alert를 만들고, 일부 provider secret은 partner integration으로 provider에 알려 revocation 같은 조치를 돕는다.[2] TruffleHog는 repo뿐 아니라 Docker image, comments 등 여러 위치의 secret 탐지를 강조하고, pre-commit/pre-receive hook으로 유출 전 차단하는 흐름을 제공한다.[4] 둘 중 하나만 고르는 문제가 아니다. hosted platform의 기본 감시, local/pre-commit gate, CI gate, 배포 전 스캔을 겹쳐야 한다.
내 자동화에 붙일 사전 게이트
이 글을 쓰면서 바로 떠오른 적용 지점은 seonoh.dev 업로드/배포 자동화다. 블로그 초안은 이미지, HTML preview, zip snapshot, 관리자페이지 업로드, Cloudflare deploy처럼 파일과 secret이 함께 움직인다. 여기에 AI draft나 agent가 끼면 “편하다”와 “위험하다”가 같은 방향으로 커진다.
그래서 다음 자동화에는 최소한 아래 gate를 붙일 수 있다.
- 작업 전 diff secret scan: 새로 stage할 파일만 먼저 스캔한다. API key, token, service account JSON,
.env가 보이면 build 전에 fail한다. - archive 전 전체 snapshot scan: zip으로 묶기 전에 제외 규칙을 확인하고, 결과 manifest에
secretScan: pass/fail을 남긴다. - preview upload key 분리: 관리자페이지 preview 업로드 key와 production deploy key를 분리한다. preview 실패가 production deploy 권한으로 번지지 않게 한다.
- AI 이미지/초안 runner 격리: ChatGPT 이미지 생성, HTML preview 생성처럼 외부 입력을 많이 다루는 runner에는 배포 key를 넣지 않는다.
- read-back 검증은 유지: 업로드 성공 메시지보다 Firestore/Storage read-back, live 200 확인이 더 중요하다. 이건 보안에서도 같다. “rotate했다”보다 실제 key가 더 이상 동작하지 않는지 확인해야 한다.
이 정도만 해도 사고 면이 꽤 줄어든다. 특히 블로그 자동화처럼 혼자 쓰는 도구일수록 “나만 쓰니까 괜찮다”가 함정이다. 혼자 쓰는 도구는 검토자가 적고, 임시 key가 오래 남고, 로컬 .env가 커지기 쉽다.
독자가 오늘 적용할 1가지
오늘 하나만 한다면 이 질문에 답하면 된다.
“우리 AI 키를 가진 프로세스 중, 내가 직접 쓰지 않은 텍스트나 코드를 읽는 프로세스는 무엇인가?”
답이 나오면 그 프로세스부터 key를 작게 만든다. production key를 eval key로 바꾸고, workspace/project를 분리하고, 월 한도와 rate limit을 낮추고, 가능한 경우 만료 시간을 둔다. 그다음 사용량 알림을 건다. 완벽한 zero trust 설계보다, 큰 shared key 하나를 작은 key 여러 개로 쪼개는 것이 먼저다.
FAQ
Anthropic 자체가 해킹당한 건가?
보고서의 cyber 사례에서 Anthropic은 API 키가 고객 환경에서 도난당했으며, Anthropic 자체 시스템이 compromise된 것은 아니라고 설명한다.[1] 핵심은 vendor 한 곳의 breach가 아니라 고객이 만든 AI integration과 agent 실행 환경이 공격 표면이 됐다는 점이다.
prompt injection만으로 API 키가 샐 수 있나?
항상 그렇지는 않다. 모델이 secret을 볼 수 없고, 파일·환경변수·네트워크·로그로 내보낼 경로가 없다면 키를 읽을 수 없다. 위험은 비신뢰 텍스트를 읽는 agent runtime이 secret과 도구 권한을 함께 가질 때 커진다.
secret scanning만 켜면 충분한가?
아니다. secret scanning은 꼭 필요하지만 유출 후 탐지에 가깝다. pre-commit/pre-receive hook, CI gate, 배포 전 archive scan, provider-side spend/rate limit, usage anomaly alert가 같이 있어야 한다.
LLM gateway를 쓰면 안전해지나?
gateway는 중앙화된 비용·라우팅·로그 관리에 도움이 되지만, 동시에 여러 provider key가 모이는 credential store가 된다. gateway가 비신뢰 입력을 직접 읽거나, agent tool과 같은 런타임에서 secret을 들고 있으면 위험이 커진다. gateway 자체도 권한 분리, key scope, audit log, rotation 절차가 필요하다.
작은 프로젝트도 이 정도를 해야 하나?
작은 프로젝트일수록 최소한의 분리가 중요하다. production key 하나를 모든 자동화에 공유하지 말고, dev/eval/preview/deploy key를 나누고 한도를 낮추는 것만으로도 피해 범위가 줄어든다.
Sources
[1] https://www.anthropic.com/threat-intelligence-report-september-2026 — Detecting and countering misuse of AI: September 2026 [2] https://docs.github.com/en/code-security/concepts/secret-security/about-secret-scanning — About secret scanning [3] https://securitylab.github.com/resources/github-actions-preventing-pwn-requests — Preventing pwn requests [4] https://trufflesecurity.com/trufflehog — What is TruffleHog?