Anthropic 사용 정책 업데이트, 에이전트 권한표부터 다시 보라는 신호다
Anthropic의 올해 시월 사용 정책 업데이트는 더 강한 Claude를 어떻게 막을지가 아니라, 자율 에이전트가 실제 계정·고객 판단·장비·외부 메시지에 닿을 때 어떤 승인과 로그를 남겨야 하는지 묻는다.
Anthropic의 올해 시월 사용 정책 업데이트를 오늘 봐야 하는 팀은 “Claude를 써도 되는지”가 궁금한 팀이 아니라 Claude나 비슷한 에이전트가 실제 계정, 고객 판단, 장비, 외부 메시지에 닿기 시작한 팀이다. 확인 기준일은 이 글의 발행일이다. Anthropic은 이번 업데이트가 긴 독립 작업, 영향력 조작, 무기 개발, 감시, 고위험 사용 사례, 자율 물리 행동 같은 패턴을 더 명확히 다룬다고 설명한다. Anthropic 정책 업데이트 결론은 간단하다. 모델을 더 많이 붙이기 전에, 먼저 우리 제품의 권한표·승인표·감사 로그를 업데이트해야 한다.
오늘의 독자 질문: 에이전트가 더 독립적으로 일하면 정책 문서는 어디까지 운영 기준이 되나
최근 seonoh.dev에서는 Haiku 최신 라우팅, 멀티모달 RAG, 팀 채널 안의 ChatGPT, 브라우저 에이전트 권한을 다뤘다. 오늘의 새 기여는 모델 선택이 아니라 정책을 운영표로 바꾸는 방법이다. 정책 문서는 법무팀만 읽는 문서처럼 보이지만, 에이전트 제품에서는 라우터와 승인 플로우의 입력값이 된다. 모델이 긴 작업을 혼자 이어가고, 도구를 부르고, 외부 시스템을 움직이면 “사용자가 시켰다”는 말만으로는 충분하지 않다.
Anthropic은 업데이트 글에서 “Claude has taken on longer, more independent work”라고 설명한다. 이 문장은 중요하다. 더 긴 작업을 맡기는 순간 위험은 답변 품질에서 실행 결과로 이동한다. 정책이 금지하는 영역을 외우는 것보다, 각 요청이 어디로 흘러가야 하는지 정하는 라벨이 필요하다.
바뀐 축은 금지 목록보다 “승격 조건”이다
정책 업데이트의 첫 번째 실무 포인트는 기만적 활동을 따로 묶었다는 점이다. Anthropic은 가짜 계정, 조작된 뉴스 사이트, 메시지 주체 은폐, 인위적 증폭 같은 행동을 “Do Not Engage in Deceptive Campaigns or Artificial Activity”라는 새 섹션으로 통합했다고 설명한다. 기만적 활동 섹션
이걸 제품 운영 언어로 바꾸면, 마케팅 자동화와 고객 커뮤니케이션 에이전트에는 별도 라벨이 필요하다. 예를 들어 “게시글 초안 작성”은 허용 가능한 생산성 작업일 수 있다. 하지만 “서로 다른 계정처럼 보이게 댓글을 나눠 올리기”, “후원 관계를 숨긴 리뷰 만들기”, “출처를 가리고 특정 메시지를 반복 증폭하기”는 모델 품질과 무관하게 차단해야 한다. 좋은 답변을 만드는 능력이 오히려 더 그럴듯한 가짜 활동을 만들 수 있기 때문이다.
따라서 운영표에는 외부 게시, 다중 계정, 출처 표기, 반복 증폭, 정치·상업 설득 같은 항목을 둬야 한다. 이 항목이 켜지면 기본 응답을 생성하지 말고, 목적·주체·표시 의무·계정 소유를 확인하는 단계로 올린다. 정책을 읽었다면 결과는 “주의하세요”가 아니라 라우터의 조건문이어야 한다.
고위험 추천은 답변이 아니라 검토 가능한 초안이다
두 번째 축은 고위험 사용 사례다. Anthropic은 건강, 법적 권리, 금융, 생계, 필수 서비스 접근에 영향을 줄 수 있는 추천에는 권한 있는 사람이 검토하고 바꿀 수 있어야 하며, 영향을 받는 개인에게 AI 사용 사실을 알려야 한다고 설명한다. 고위험 사용 요건
이 문장은 고객지원 자동화에서 특히 중요하다. 환불 거절, 대출 가능성, 보험 심사, 계정 정지, 채용 평가처럼 사람에게 남는 결과가 큰 작업은 “모델이 자신 있게 말했는가”가 기준이 아니다. 기준은 권한 있는 담당자가 결과를 볼 수 있는가, 바꿀 수 있는가, 사용자가 AI 개입을 알 수 있는가다.
실무적으로는 답변 템플릿을 두 갈래로 나누면 된다. 낮은 위험 작업은 바로 답변해도 된다. 주문 상태 안내, 문서 요약, 회의록 정리, 공개 문서 기반 설명은 여기에 가깝다. 반면 권리·돈·건강·계정 접근에 영향을 주는 작업은 “최종 결정”이 아니라 “검토 초안”으로 저장한다. 버튼 이름도 바뀌어야 한다. 자동 발송이 아니라 담당자 검토로 보내기가 맞다.
물리 행동이 들어오면 권한표가 안전표가 된다
세 번째 축은 자율 물리 행동이다. Anthropic은 Model Hardware Standard 이후, 모델이 부상 위험이 있는 장비와 연결될 때 자격 있는 운영자가 장비를 관찰하고 필요하면 멈출 수 있어야 하며, Claude 연결이 끊겨도 장비가 안전 상태를 유지해야 한다고 설명한다. 자율 물리 행동 요건
이 내용은 로봇 회사만의 이야기가 아니다. 운영 자동화가 서버 재시작, 배포, 결제 정산, 광고 캠페인, 대량 이메일, 파일 삭제처럼 현실 비용을 만드는 작업에 닿으면 같은 사고방식이 필요하다. 손가락을 움직이는 로봇 팔이 아니어도, 되돌리기 어려운 결과를 만드는 버튼은 물리 행동과 비슷하게 다뤄야 한다.
그래서 권한표에는 “읽기”, “초안 생성”, “내부 저장”, “외부 발송”, “삭제”, “결제”, “장비 제어” 같은 단계가 필요하다. 에이전트가 어디까지 할 수 있는지 한 줄로 쓰는 대신, 각 단계마다 로그·승인·롤백·정지 방법을 둔다. 정책은 금지선을 긋지만, 제품팀의 일은 그 금지선을 사용자가 누르는 버튼과 운영자가 보는 로그로 바꾸는 것이다.
보안 프로그램은 “방어자는 더 많은 권한, 더 강한 검증”으로 간다
같은 주 발표된 Anthropic Cyber Mission과 Cyber Verification Program도 같은 방향을 보여준다. Anthropic은 Cyber Mission에서 중요 인프라와 오픈소스 보안을 지원하겠다고 했고, Critical Infrastructure Defense Program과 OSS Scanner를 시작한다고 설명한다. Anthropic Cyber Mission Cyber Verification Program 글은 방어 작업, 레드팀, 특수 접근을 서로 다른 접근 등급으로 나누고, 각 등급에 검증 요건과 보안 통제를 둔다고 설명한다. Cyber Verification Program
여기서 배울 점은 “보안 작업이면 다 허용”도 아니고 “위험하니 다 막자”도 아니라는 것이다. 같은 취약점 분석이라도 내가 소유한 코드의 패치와, 타인의 시스템을 상대로 한 침투 테스트는 다르다. 방어자에게는 강한 도구가 필요하지만, 그 강한 도구는 검증된 주체·허가된 범위·감사 가능한 작업으로 묶여야 한다.
오늘 바꿀 운영 체크리스트
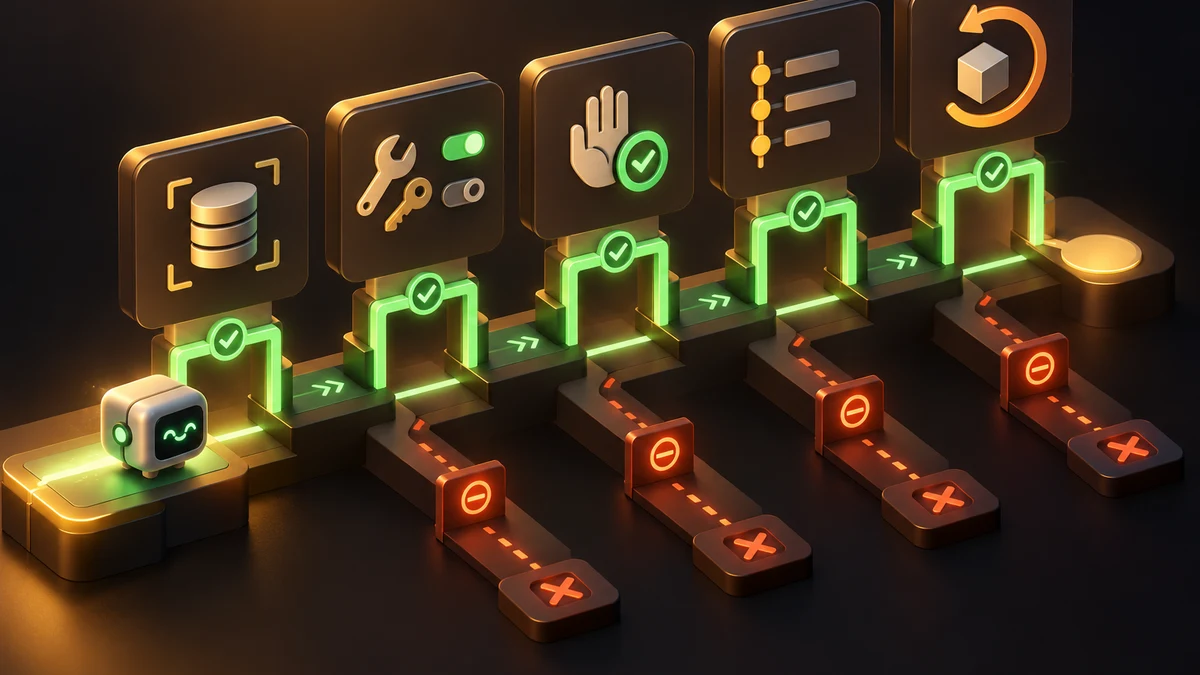
오늘 당장 바꿀 수 있는 것은 거창하지 않다.
첫째, 요청을 읽기, 초안, 내부 변경, 외부 영향, 되돌리기 어려운 실행으로 나눈다. 둘째, 기만적 활동 신호를 별도 라벨로 둔다. 셋째, 건강·법률·금융·고용·필수 서비스 접근에 닿는 답변은 최종 결정이 아니라 검토 초안으로 보낸다. 넷째, 장비·배포·삭제·결제처럼 현실 결과가 있는 작업에는 정지 수단과 롤백 방법을 기록한다. 다섯째, 방어 목적의 보안 자동화도 소유 범위와 허가 범위를 로그로 남긴다.
실패 조건도 분명하다. 정책 링크를 약관 페이지에만 넣고 제품 라우터를 바꾸지 않으면 아무것도 바뀌지 않는다. “우리 에이전트는 내부용”이라는 이유로 외부 발송과 삭제 권한을 한꺼번에 열면 사고 범위가 커진다. 사람 검토를 둔다고 해도 담당자가 무엇을 보고 바꿀 수 있는지 없으면 검토가 아니라 형식이다.
FAQ
이번 업데이트는 Anthropic 사용자에게만 중요한가
직접 적용되는 것은 Anthropic 제품과 서비스다. 다만 긴 독립 작업, 고위험 추천, 물리 행동, 기만적 활동 같은 구분은 다른 모델을 쓰는 에이전트 제품에도 그대로 참고할 만한 운영 축이다.
정책을 지키려면 자동화를 줄여야 하나
무조건 줄일 필요는 없다. 대신 자동화를 초안, 추천, 실행으로 나누고, 실행 단계로 갈수록 승인과 로그를 두는 편이 안전하다.
사람 검토를 넣으면 충분한가
아니다. 검토자가 권한과 맥락을 가지고 결과를 바꿀 수 있어야 한다. 단순히 “사람이 봤다”는 체크박스만 있으면 고위험 사용 사례의 품질과 책임을 설명하기 어렵다.
오늘 개발팀이 먼저 볼 파일은 무엇인가
정책 문서 자체보다 제품의 권한 매트릭스, 도구 호출 allowlist, 외부 발송 플로우, 삭제·결제·배포 로그를 먼저 본다. 정책은 그 표를 고치기 위한 기준이다.