AI 에이전트 권한, 샌드박스만으로 부족하다: 런타임 경계와 데이터 경계를 나누는 법
NVIDIA OpenShell과 AWS TOLAP 발표를 같이 읽으면 에이전트 보안의 위치가 더 분명해진다. 샌드박스는 프로세스·네트워크 행동을 막고, 데이터 소스 정책은 row·column·field가 컨텍스트에 들어오기 전에 막는다. 작은 팀이 도구별로 어디에 게이트를 둘지 결정하는 실무 표로 정리했다.
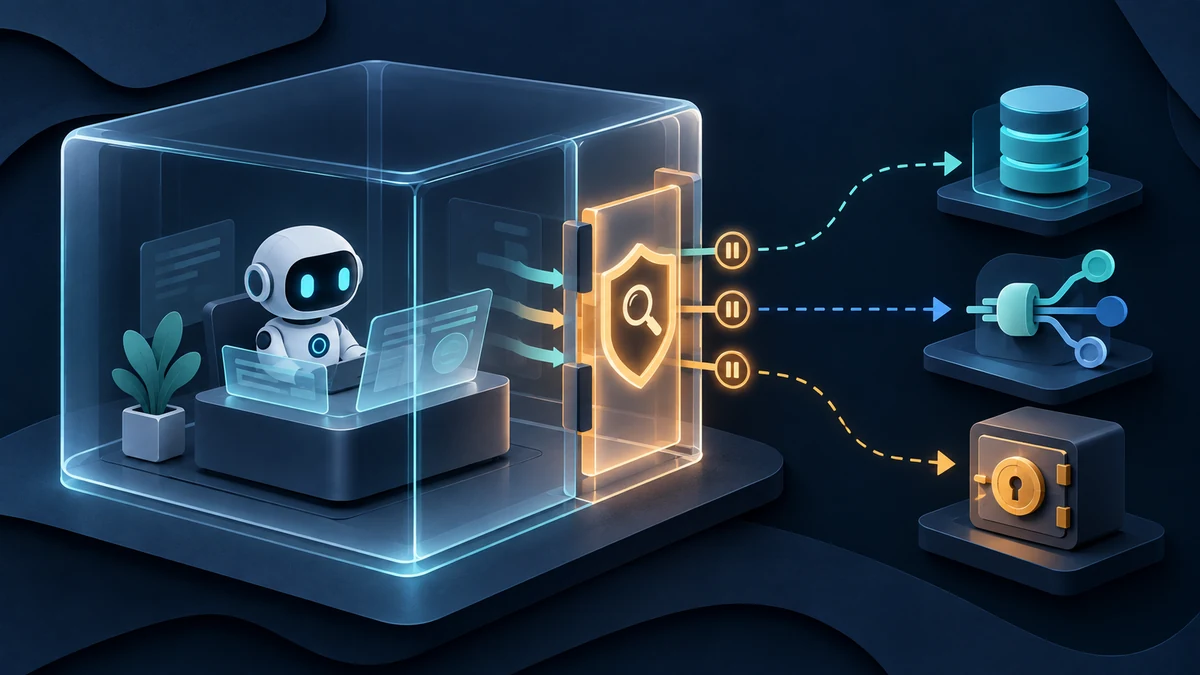
AI 에이전트에게 저장소, 데이터베이스, 사내 API, 고객 자료를 열어줄 때 샌드박스 하나만 붙이면 끝나는 것이 아니다. 샌드박스는 에이전트의 프로세스·파일·네트워크 행동을 바깥에서 제어하고, 데이터 소스 권한은 row·column·field가 모델 컨텍스트에 들어오기 전에 줄인다. 2026년 9월 29일 기준으로 NVIDIA OpenShell 0.1.0과 AWS TOLAP 공개 자료를 함께 읽으면, 작은 팀이 오늘 정해야 할 질문은 “어떤 제품을 살까”보다 “각 도구의 권한 경계가 어디에 있는가”에 가깝다.
오늘의 독자 질문: 에이전트에게 도구를 열 때 권한은 어디서 막아야 하나
최근 seonoh.dev의 글들은 GEO 관측, 로컬 에이전트, tool call 직전의 의도 판정을 다뤘다. 어제 글이 “정상처럼 보이는 tool call도 실행 직전에 의도를 봐야 한다”였다면, 오늘의 새 기여는 한 층 더 운영 쪽이다. 런타임 경계와 데이터 경계를 나눠서, 어떤 실패를 어느 위치에서 막을지 고르는 표를 만든다.
NVIDIA는 2026년 9월 28일 OpenShell 0.1.0을 소개하며, 기존 에이전트를 다시 쓰지 않고도 샌드박스·서비스 접근 제어·자격증명 보호·정책 분석을 외부 런타임에서 적용하는 구조를 설명했다. OpenShell Gateway, Supervisor, Sandbox가 에이전트 fleet과 outbound request를 관리하고, 파일·프로세스·네트워크 경계를 적용한다는 설명이다. NVIDIA Technical Blog · OpenShell
AWS는 2026년 9월 22일 TOLAP을 공개하며 다른 빈틈을 짚었다. agent가 tool을 호출할 권한이 있어도, 그 tool이 데이터베이스·API·지식베이스·오브젝트 스토리지에서 어떤 row·column·field를 돌려줘도 되는지는 별도 문제라는 것이다. TOLAP은 source-point enforcement, object granularity, agent transparency를 원칙으로 삼고, 제한된 데이터가 애초에 agent context에 들어오지 않게 한다고 설명한다. AWS Open Source Blog · TOLAP
이 글의 적용 조건은 명확하다. 읽기 전용 요약봇보다, 사내 데이터 조회·고객 지원 자동화·코드 변경·배포·권한 변경처럼 실패 비용이 있는 agent를 운영하려는 팀에 맞다. 반대로 개인 메모 정리나 임시 초안 생성처럼 외부 상태를 바꾸지 않는 일은 이 구조를 더 가볍게 줄여도 된다.
샌드박스가 잘 막는 것: 에이전트의 행동 경로
OpenShell류 런타임 경계가 맡는 일은 “에이전트가 어떤 행동을 실제로 할 수 있는가”다. NVIDIA 설명에서 OpenShell Sandbox는 workload를 격리하고, Supervisor는 sandbox 바깥에서 outbound request를 정책과 대조하며, Gateway는 여러 sandbox의 lifecycle과 policy를 관리한다. 중요한 점은 이 검사가 agent workload 바깥에 있다는 것이다. 에이전트가 설득력 있게 말해도 supervisor 경계를 그냥 통과할 수 없어야 한다. NVIDIA · Gateway/Supervisor/Sandbox
NVIDIA가 든 예시는 GitHub REST API에 read-only 접근을 허용하고 POST를 막는 식이다. 같은 서비스라도 읽기는 허용하고 쓰기는 막을 수 있으며, HTTP·GraphQL·MCP traffic을 검사해 정책을 적용한다는 설명이다. 또한 실제 credential은 agent workload 안에 두지 않고, 허용된 endpoint에 대해서만 supervisor/proxy가 대체해 전달하는 구조를 제시한다. NVIDIA · credential-protected service access
이 층이 특히 유효한 실패는 아래와 같다.
| 실패 유형 | 런타임 경계가 보는 것 | 예시 대응 |
|---|---|---|
| 허용되지 않은 네트워크 호출 | host, port, protocol, HTTP method | GitHub API read는 허용, write는 차단 |
| 로컬 파일·프로세스 남용 | sandbox filesystem, process, privilege | 작업 폴더 밖 파일 읽기·권한 상승 차단 |
| 자격증명 탈취·오용 | credential binding, approved endpoint | 대체 자격증명 토큰이 다른 host로 나가면 거부 |
| 실행 중 권한 확장 | policy proposal, human review | agent가 스스로 권한을 승인하지 못하게 함 |
작은 팀에 필요한 첫 작업은 제품 설치가 아니라 도구별 outbound surface를 적는 일이다. agent가 어느 host에 연결하고, 어떤 method를 쓰고, 어떤 credential이 필요하고, write가 가능한지부터 표로 만든다. 그 표가 없으면 샌드박스 정책도 결국 감으로 짜게 된다.
데이터 권한이 막는 것: 컨텍스트에 들어오는 내용
런타임 샌드박스가 agent의 발과 손을 묶는다면, TOLAP류 데이터 경계는 agent의 눈에 들어오는 정보를 줄인다. AWS 글의 핵심 예시는 의료 데이터다. agent가 clinical database를 조회하는 tool을 호출할 수 있어도, 현재 사용자에게 SSN column이나 특정 region 밖 row를 보여줘도 되는지는 다른 질문이다. content guardrail이 답변에서 SSN을 지워도, 이미 unrestricted data가 context에 들어왔다면 prompt injection이나 후속 질문으로 새어나갈 수 있다는 지적이다. AWS · content guardrail 한계
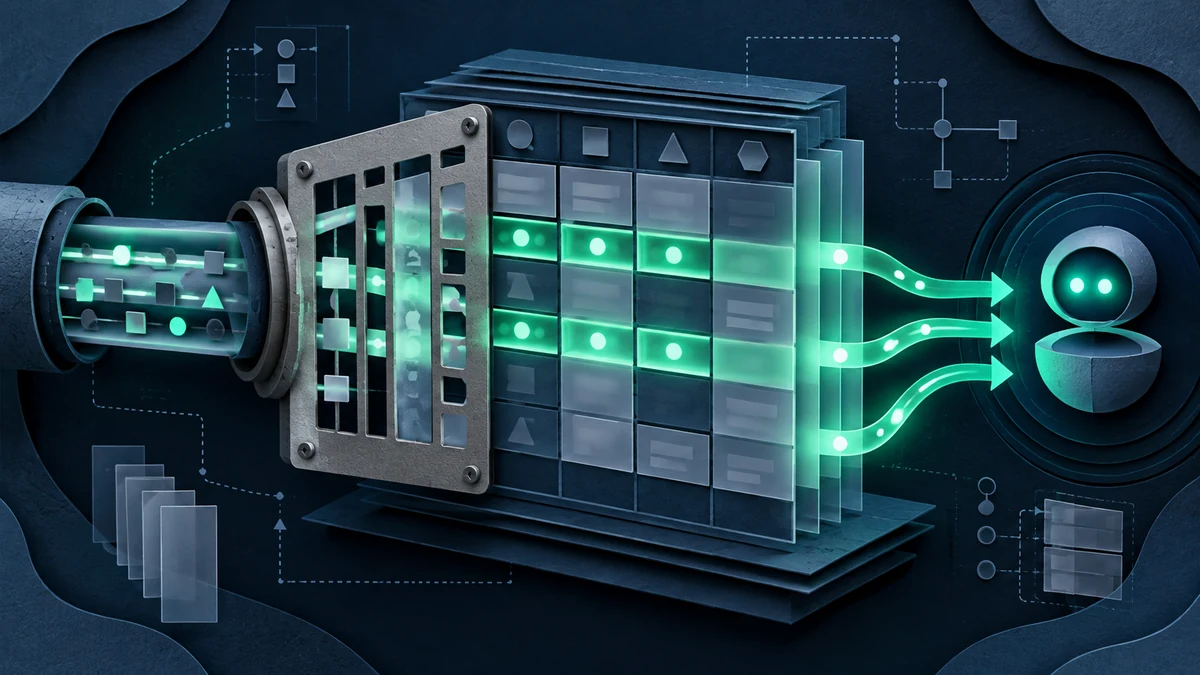
TOLAP의 구조는 세 단계로 요약할 수 있다. 사용자와 데이터 소스에 대해 effective policy를 resolve하고, 그 정책을 서명된 시간 제한 context로 만들며, tool이 결과를 agent에게 돌려주기 전에 enforcement를 적용한다. AWS는 allowed set은 교집합, denied set은 합집합, numeric limit은 더 엄격한 값으로 합치는 “most-restrictive-wins” 병합 규칙도 설명한다. AWS · policy merge
이 층이 특히 유효한 실패는 아래와 같다.
| 실패 유형 | 데이터 경계가 보는 것 | 예시 대응 |
|---|---|---|
| 불필요한 column 노출 | field/column allow·deny | SSN 제거, email hash, name mask |
| 과도한 row 접근 | row filter, tenant, region | 담당 지역 row만 반환 |
| 목적 밖 조회 | purpose profile, allowed action | campaign 분석 목적이면 billing table 제외 |
| sub-agent 권한 확대 | delegation chain narrowing | 각 hop이 scope를 좁히는지만 허용 |
여기서 중요한 한계도 AWS가 직접 적었다. TOLAP wrapper를 쓰지 않는 직접 database access는 보호하지 못한다. signed context도 optional replay guard 없이는 expiry 전 replay 가능성이 있다. LLM judge는 비결정적이므로 compliance gate로 단독 사용하기 어렵다. 즉 데이터 경계는 강력하지만, 모든 경로가 그 wrapper를 지나도록 설계해야 의미가 있다. AWS · limitations
두 경계는 경쟁하지 않는다
샌드박스와 데이터 정책은 같은 문제를 다른 말로 부르는 것이 아니다. 하나는 어디로 무엇을 실행할 수 있는가를 보고, 다른 하나는 무엇이 agent context에 들어와도 되는가를 본다. 그래서 둘 중 하나만 고르면 사각지대가 남는다.
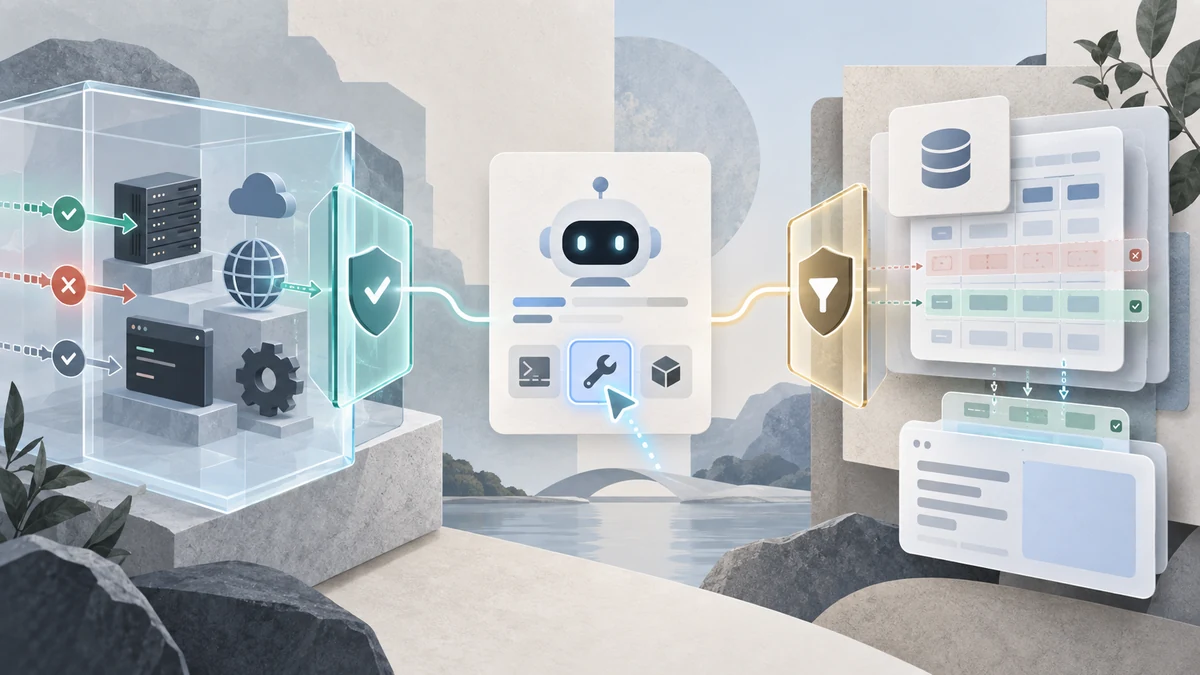
예를 들어 GitHub read-only 정책은 POST를 막을 수 있다. 하지만 read로 가져온 데이터 안에 agent가 볼 필요 없는 secret-like field가 포함되어 있으면, 런타임 경계만으로는 그 field를 context에서 제거하지 못한다. 반대로 column masking이 잘 되어 있어도, agent가 허용되지 않은 외부 host로 데이터를 보내거나 shell에서 파일을 지우면 데이터 정책만으로는 막기 어렵다.
실무에서는 아래처럼 배치하면 된다.
| 도구/작업 | 먼저 필요한 경계 | 이유 | 추가로 붙일 경계 |
|---|---|---|---|
| 공개 API 읽기 | 런타임 경계 | host·method·rate limit이 핵심 | 민감 field가 있으면 데이터 필터 |
| 고객 DB 조회 | 데이터 경계 | row·column·tenant 권한이 핵심 | query path와 credential은 런타임에서 제한 |
| 저장소 패치 | 런타임 경계 | 파일 범위·명령·네트워크·write method 제어 | diff 안의 secret 노출 검사 |
| 분석용 sub-agent 위임 | 데이터 경계 + 위임 사슬 | 목적과 scope가 hop마다 좁아져야 함 | sandbox별 outbound 제한 |
| 배포·권한 변경 | 런타임 경계 + 사람 승인 | write 실패 비용이 큼 | 결과 read-back과 audit log |
이 표의 목적은 완벽한 아키텍처를 선언하는 것이 아니다. agent에게 tool을 열기 전에 “어떤 위험은 어디서 막고, 어디는 아직 못 막는가”를 빠르게 드러내는 것이다.
목적과 위임 사슬을 남겨야 하는 이유
AWS TOLAP 글에서 흥미로운 부분은 purpose-binding과 delegation chains다. 목적은 agent가 “좋은 일을 하려 한다”는 주장으로 믿는 값이 아니다. policy selector다. agent가 campaign-overlap 목적을 고르면, 그 목적에 묶인 customer segment와 campaign assignment만 보이고 fraud investigation table은 애초에 resolve되지 않는다. 거짓 목적을 고르면 더 많은 데이터가 열리는 것이 아니라, 그 목적의 좁은 정책만 받게 되는 구조다. AWS · purpose-binding
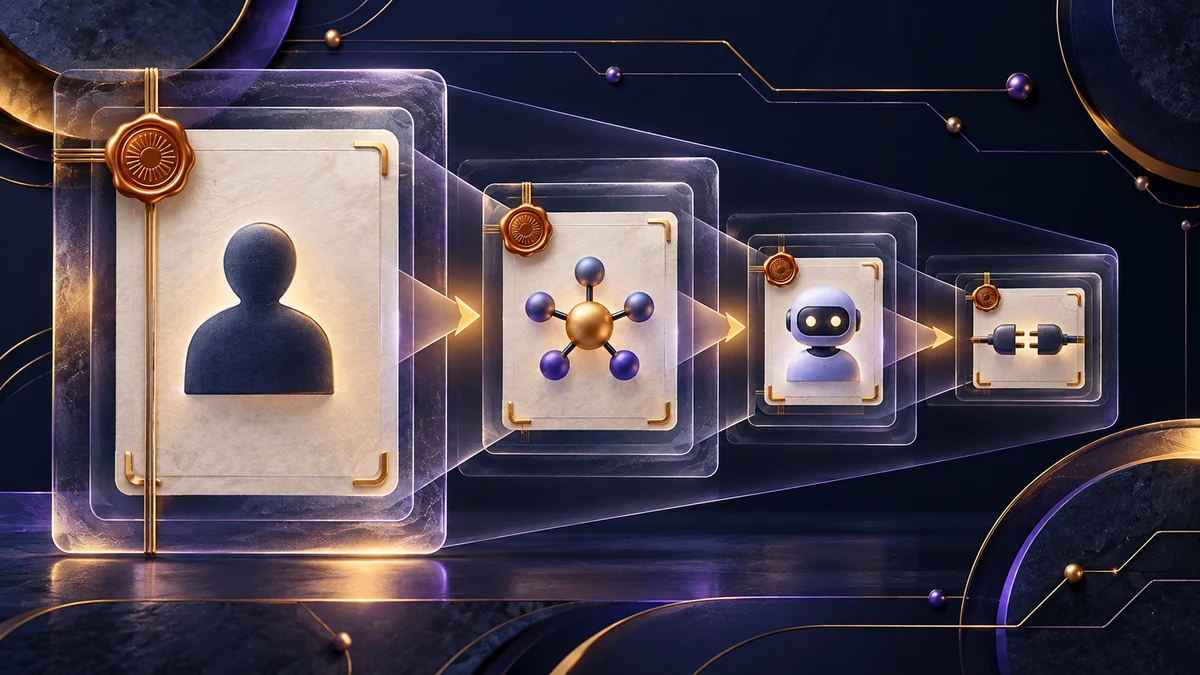
Delegation chain은 human user → orchestrator → sub-agent → tool endpoint 같은 경로를 기록한다. 각 hop은 scope를 넓힐 수 없고 좁힐 수만 있어야 한다. 이 생각은 작은 팀에도 바로 쓸 수 있다. “이 agent는 관리자 bot이니까 다 된다”가 아니라, 요청마다 아래 네 줄을 남긴다.
human_principal: 누가 시작했나
agent_purpose: 왜 실행하나
allowed_tools: 어떤 도구까지인가
denied_or_escalate: 어떤 조건이면 사람에게 돌리나
이 네 줄이 없으면 사고 후에는 “누가 시켰는지”, “agent가 왜 그 데이터를 봤는지”, “sub-agent가 권한을 넓힌 것인지”를 설명하기 어렵다. 로그는 나중에 책임을 묻기 위한 장식이 아니라, 실행 전에 권한을 좁히는 입력이어야 한다.
작은 팀용 30분 설계 절차
거창한 control plane을 만들기 전에 아래 순서로 한 도구만 골라 적어보자. 예시는 “고객 지원 agent가 주문 조회와 환불 제안을 한다”는 상황이다.
- 도구 목록을 쓴다.
lookup_order,calculate_refund,issue_refund,send_email처럼 이름을 나눈다. - 실패 비용을 붙인다. 조회, 개인정보 노출, 금전 변경, 외부 발송, 권한 변경 중 무엇인지 표시한다.
- 런타임 경계를 적는다. 어떤 host와 method를 허용하고, write는 어디서 막을지 정한다.
- 데이터 경계를 적는다. 어떤 field·row·tenant·purpose만 agent context에 들어오는지 정한다.
- 세션 로그를 정한다. 같은 주문·사용자·저장소에 반복 write가 누적되는지 기록한다.
- 사람 승인 조건을 정한다. 한도 초과, 권한 변경, 외부 공개, policy proposal은 자동 실행하지 않는다.
- read-back을 정한다. 실행 후 실제 DB/API/파일 상태를 다시 읽어 완료를 판단한다.
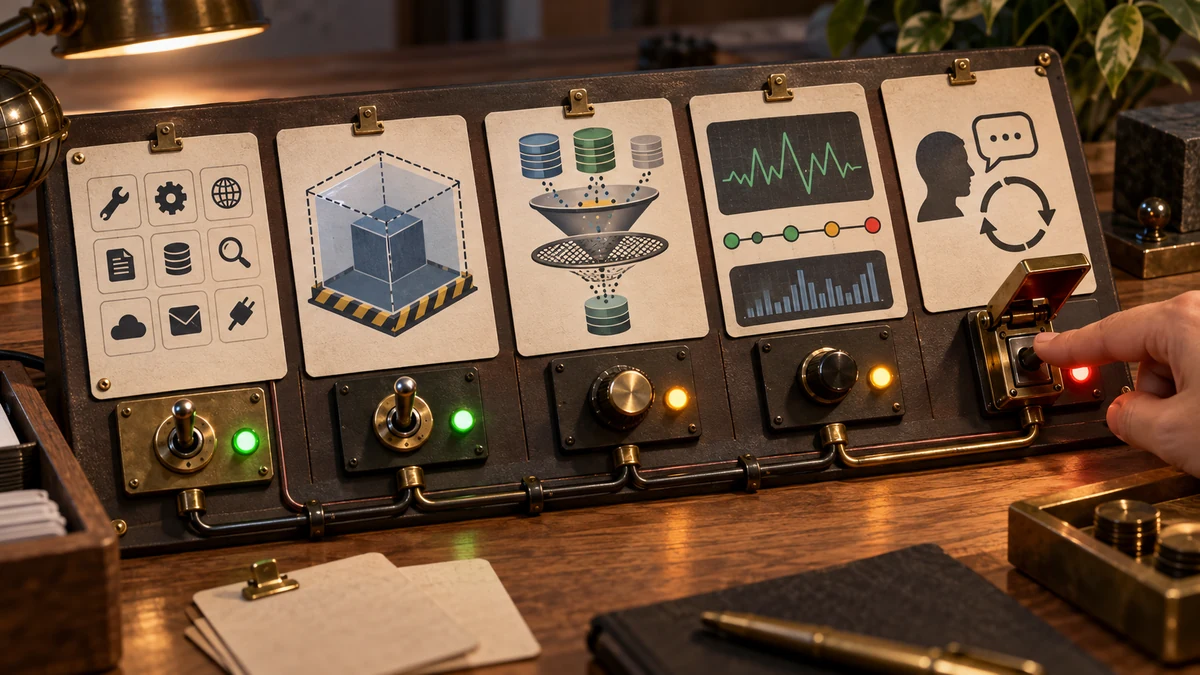
처음에는 모든 항목이 자동화되지 않아도 된다. 중요한 것은 빈칸을 아는 것이다. 예를 들어 데이터 필터가 없다면 그 tool은 고객 전체 데이터를 agent context에 넣는지 확인해야 한다. runtime method filter가 없다면 read-only라고 믿던 credential이 실제로 POST를 할 수 있는지 확인해야 한다.
로컬·클라우드·MCP에 그대로 적용하기
이 기준은 특정 vendor 제품에만 묶이지 않는다. 로컬 coding agent도 shell과 파일 경계가 필요하고, cloud-hosted agent도 data source 경계가 필요하다. MCP server를 쓰는 경우에는 더 조심해야 한다. agent가 MCP server에 연결할 권한이 있다는 사실과, 그 server가 backend credential로 어떤 request를 만들 수 있는지는 다르다.
Google의 zero-trust agent 글도 tool call 전 의도 판정과 session anomaly detection을 runtime governance로 설명했다. 여기서 오늘의 기준을 붙이면 구조가 더 선명해진다. prompt filter와 semantic policy는 “이 tool call을 실행해도 되는가”를 보고, OpenShell류 경계는 “실제 행동이 허용된 경로인가”를 보며, TOLAP류 경계는 “반환되는 데이터가 필요한 범위인가”를 본다. Google Developers · Zero-trust Agents
Cloudflare가 검색·학습·agent crawler를 분리해 제어한다고 발표한 것도 같은 방향의 신호다. “AI traffic”이라고 한 덩어리로 부르지 않고 search, training, agent라는 목적을 나누면 정책이 구체화된다. 내부 agent 도구도 마찬가지다. 읽기, 학습, 요약, 쓰기, 배포, 외부 발송을 하나의 allow로 묶으면 사고가 난다. Cloudflare · AI crawler controls
실패 조건과 한계
이 글은 OpenShell이나 TOLAP을 모든 팀에 즉시 도입하라는 구매 가이드가 아니다. NVIDIA와 AWS가 설명한 기능은 각각의 오픈소스 프로젝트·제품 조건과 deployment 전제가 있다. 글에서 제안한 표는 두 자료의 공통 운영 질문을 뽑은 것이며, 특정 환경에서의 보안 인증이나 성능 보장을 뜻하지 않는다.
또한 샌드박스와 데이터 정책을 모두 붙여도 정책 자체가 틀리면 실패한다. 허용 목록에 위험한 host가 들어가 있거나, 데이터 wrapper를 우회하는 직접 DB 경로가 남아 있거나, 사람 승인 조건이 너무 넓으면 agent는 여전히 사고를 낼 수 있다. 그래서 마지막 게이트는 항상 실제 상태 read-back과 audit log다.
오늘 적용할 한 가지는 간단하다. agent가 호출하는 tool 하나를 골라 아래 문장을 채운다.
이 tool은 [무엇을 바꿀 수 있고],
runtime에서는 [host/method/file/process]를 막으며,
data source에서는 [row/column/field/purpose]를 줄이고,
[조건]이면 사람에게 돌리고,
완료는 [read-back 대상]으로 확인한다.
이 문장을 못 채우는 tool은 아직 자동 실행할 준비가 안 된 것이다.
자주 묻는 질문
샌드박스를 쓰면 데이터 필터는 없어도 되나?
아니다. 샌드박스는 주로 실행 경로와 외부 행동을 막는다. tool이 허용된 경로로 너무 많은 데이터를 가져오면, 그 데이터는 여전히 agent context에 들어갈 수 있다. 민감 field와 row는 source에서 줄여야 한다.
데이터 필터가 있으면 prompt injection은 덜 걱정해도 되나?
일부 위험은 줄어든다. 애초에 context에 없는 SSN이나 billing table은 추출하기 어렵다. 그러나 prompt injection이 허용된 tool을 악용해 외부 전송, 반복 조회, 정책 회피를 시도할 수 있으므로 runtime·session telemetry도 필요하다.
LLM judge로 권한 판정을 해도 되나?
보조 판정으로는 쓸 수 있지만, 단독 compliance gate로 두기는 어렵다. AWS도 LLM judge를 deterministic enforcement 이후의 선택적 semantic alignment layer로 설명하고, 비결정성 한계를 밝힌다. 먼저 deterministic deny, scope narrowing, result limit을 둬야 한다.
MCP 서버는 어디에 넣어야 하나?
MCP는 tool 연결 방식일 뿐이다. inbound authentication, per-tool authorization, parameter 제한, backend credential 보호, 데이터 반환 필터를 따로 봐야 한다. MCP server가 privileged backend credential을 들고 있다면 runtime 경계와 데이터 경계를 더 강하게 적용해야 한다.
작은 팀은 무엇부터 시작해야 하나?
한 agent의 tool inventory부터 만든다. 읽기·쓰기·공개·삭제·배포·권한 변경으로 분류하고, 가장 위험한 write tool 하나에 runtime allowlist, 데이터 field filter, 사람 승인 조건, read-back 대상을 붙인다. 그다음 반복 write와 누적 범위를 로그로 남긴다.
참고 자료
- NVIDIA Technical Blog — Add Runtime Controls to AI Agents with NVIDIA OpenShell
- AWS Open Source Blog — Introducing TOLAP: object-level access control for AI agent tools
- Google Developers — Build zero-trust AI agents that judge intent, not just syntax
- Cloudflare Press Release — Helps End the Search-or-AI-Training Tradeoff
자료 확인일: 2026년 9월 29일. 본문 이미지는 OpenAI Codex 이미지 백엔드로 생성한 개념 이미지이며 실제 제품 화면, 보안 인증 결과, 특정 vendor 조합의 성능 보장을 의미하지 않는다.