SEO 완전 가이드: 검색엔진이 내 사이트를 발견하고 이해하는 과정
SEO는 검색 순위 트릭이 아니라 검색엔진이 공개 웹페이지를 발견·크롤링·렌더링·인덱싱·평가하도록 만드는 웹 운영 기술이다. Discovery부터 SERP까지의 흐름을 기준으로 개발자와 콘텐츠 작성자가 무엇을 구현하고 어떻게 검증해야 하는지 정리한다.
SEO를 “검색 순위 올리는 기술”로만 보면 중요한 절반을 놓친다. 검색엔진은 먼저 URL을 발견하고, 서버에서 문서를 가져오고, JavaScript를 렌더링하고, 중복 문서를 묶고, 인덱스에 저장한 뒤, 사용자의 검색 의도에 맞춰 결과를 보여준다. 따라서 SEO는 글쓰기만의 문제가 아니라 HTML, HTTP, 렌더링, 정보 구조, 배포 운영, 보안까지 이어지는 웹사이트 품질 관리다.
이 글은 SEO/GEO/AEO 연재의 1편이다. GEO와 AEO 본문은 뒤에서 따로 다루지만, SEO 편에서도 이후 비교를 위해 “기계가 이해하기 쉬운 구조”, “출처와 인용 가능성”, “질문과 답변 구조”가 어디에서 연결되는지는 기록한다. 기준 시점은 2026년 9월 24일이다.
한 줄 요약
SEO(Search Engine Optimization)는 검색엔진이 공개 웹페이지를 발견하고, 접근하고, 이해하고, 적절한 검색어에 대해 검색결과로 제공할 수 있도록 사이트와 콘텐츠를 개선하는 작업이다. Google도 SEO를 “검색엔진이 콘텐츠를 이해하도록 돕고, 사용자가 검색을 통해 사이트를 발견하고 방문 여부를 판단하도록 돕는 일”로 설명한다.Google 공식
이 정의에서 중요한 단어는 “도움”이다. SEO는 검색엔진을 속이는 방법이 아니다. 크롤러가 접근할 수 있고, 렌더러가 볼 수 있고, 인덱서가 대표 URL과 주제를 이해할 수 있고, 사용자가 결과에서 클릭할 이유를 판단할 수 있게 만드는 일이다.
SEO가 필요한 이유: 검색엔진은 자동이지만 완벽하지 않다
Google Search는 자동화된 검색엔진이지만, 모든 페이지를 자동으로 완벽하게 크롤링·인덱싱·노출하지는 않는다. Google은 Search가 크게 crawling, indexing, serving search results 단계로 작동하며, 모든 페이지가 각 단계를 통과하는 것은 아니라고 설명한다.Google 공식
운영자가 SEO를 해야 하는 이유는 세 가지다.
| 목표 | 검색 시스템의 질문 | 운영자가 제어할 수 있는 것 |
|---|---|---|
| 발견 가능성 | 이 URL을 알 수 있는가? | 내부 링크, sitemap, canonical URL, 외부 링크 |
| 처리 가능성 | 페이지를 가져오고 렌더링할 수 있는가? | HTTP 상태, robots.txt, JavaScript 렌더링, 서버 안정성 |
| 선택 가능성 | 이 페이지가 해당 검색 의도에 좋은 답인가? | 제목, 구조, 본문 깊이, 출처, 이미지, 사용자 경험 |
좋은 SEO는 이 세 질문에 순서대로 답한다. 글이 좋아도 URL이 발견되지 않으면 검색에 나오지 않는다. URL이 발견돼도 noindex나 rendering 오류가 있으면 인덱싱되지 않는다. 인덱싱돼도 검색 의도와 맞지 않으면 노출과 클릭이 약하다.
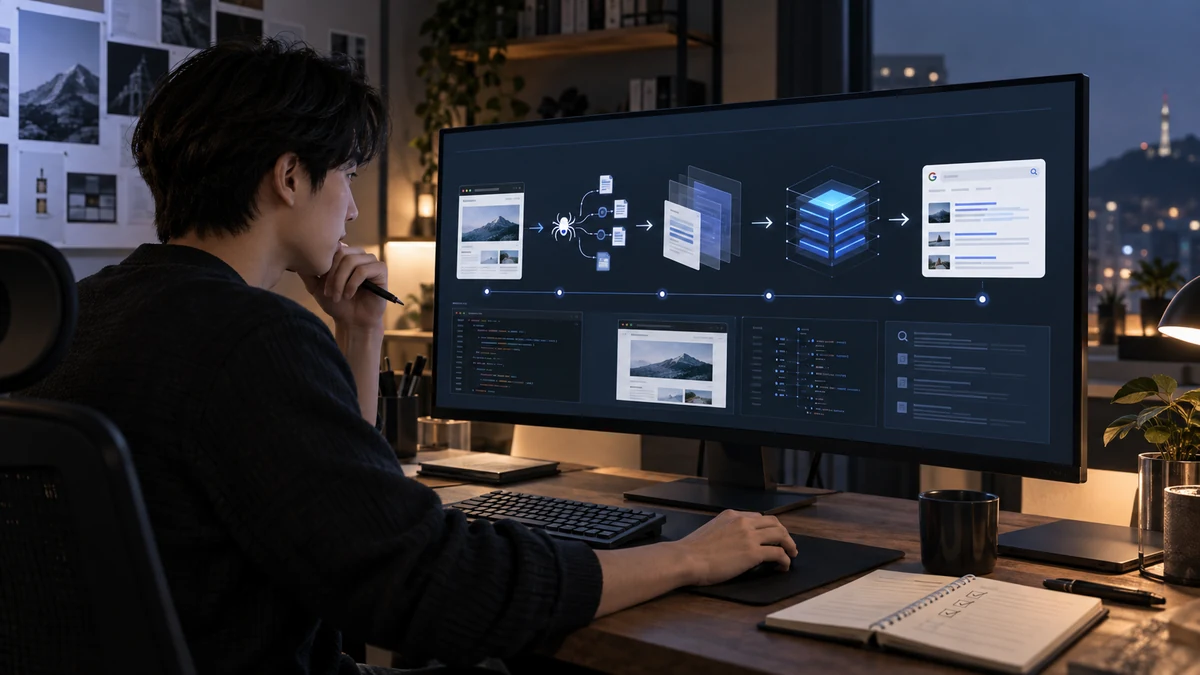
검색엔진의 처리 흐름: Discovery에서 SERP까지
SEO를 설정 목록으로 외우면 금방 헷갈린다. robots.txt, noindex, canonical, sitemap.xml은 모두 “검색 노출”과 관련 있지만 작동 위치가 다르다. 그래서 먼저 검색엔진의 처리 흐름을 잡아야 한다.
웹사이트
  ↓
Discovery: URL 발견
  ↓
Crawling: HTTP 요청으로 문서와 리소스 다운로드
  ↓
Rendering: JavaScript 실행 후 사용자가 보는 DOM에 가깝게 해석
  ↓
Indexing: 콘텐츠·메타데이터·canonical·언어·이미지 분석
  ↓
Retrieval: 검색어와 관련 있는 후보 문서 검색
  ↓
Ranking: 여러 신호로 후보 정렬
  ↓
SERP: title link, snippet, rich result 등으로 표시
Google은 URL discovery가 기존에 알려진 페이지의 링크, sitemap 제출, 이미 방문한 URL 등에서 시작된다고 설명한다.Google 공식 이 말은 내부 링크가 SEO의 기초라는 뜻이기도 하다. 중요한 페이지가 sitemap에만 있고 사이트 어디에서도 링크되지 않는다면, 검색엔진과 사용자 모두에게 약한 페이지가 된다.
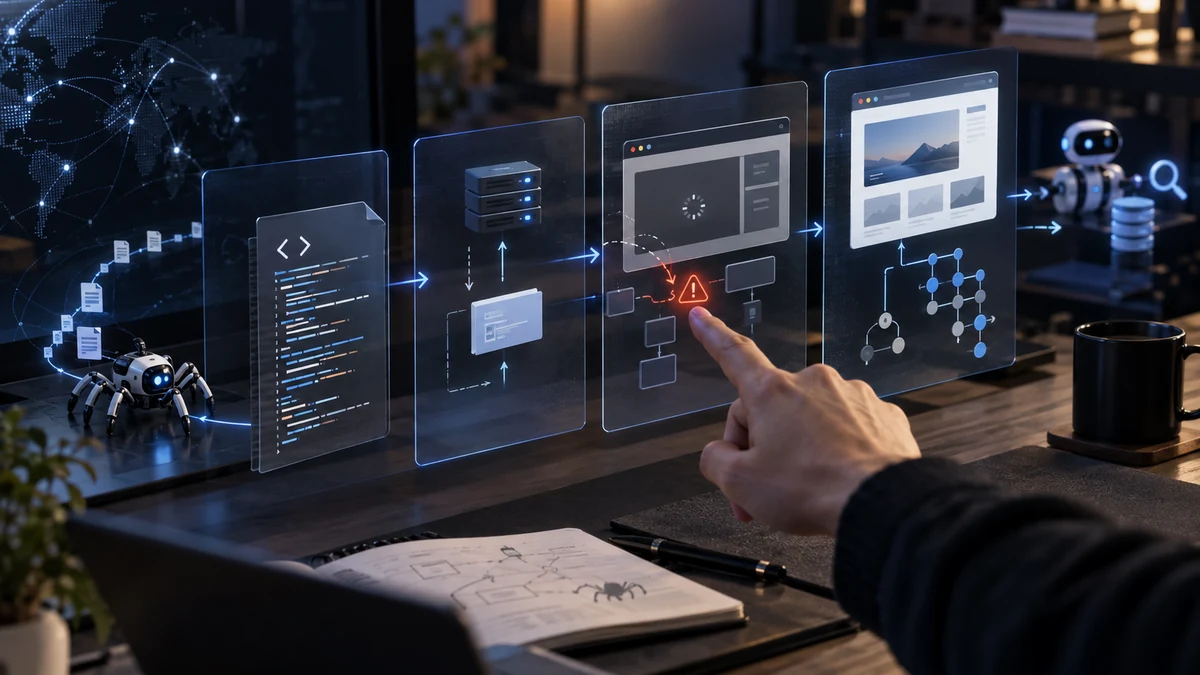
Crawling: 검색엔진이 페이지를 가져오는 단계
Crawling은 Googlebot 같은 크롤러가 URL에 HTTP 요청을 보내 문서와 리소스를 가져오는 단계다. Googlebot은 어떤 사이트를 얼마나 자주, 얼마나 많이 가져올지 알고리즘적으로 결정하고, 서버 과부하를 피하기 위해 응답 상태를 고려한다.Google 공식
개발자가 가장 먼저 볼 것은 HTTP 상태다.
| 상황 | 권장 상태 | 검색 관점 의미 |
|---|---|---|
| 정상 페이지 | 200 | 크롤링·인덱싱 후보가 될 수 있다. |
| 영구 이전 | 301 또는 308 | 새 URL로 이동했음을 알린다. |
| 임시 이전 | 302 또는 307 | 일시적으로 다른 URL을 제공한다. |
| 삭제 또는 없음 | 404 또는 410 | 인덱스에서 제거될 수 있다. |
| 권한 필요 | 401 또는 403 | 공개 검색 대상이 아님을 나타낸다. |
| 서버 오류 | 5xx | 반복되면 크롤링 안정성과 사용자 경험에 문제가 된다. |
Before / After: 없는 상품 페이지가 200으로 응답하는 경우
Before
GET /products/old-item
HTTP/1.1 200 OK
본문에는 “상품을 찾을 수 없습니다”만 표시된다.
문제
사용자에게는 오류 페이지인데 서버는 정상 페이지라고 말한다. 검색엔진은 이런 페이지를 soft 404로 판단하거나, 불필요한 URL을 계속 크롤링할 수 있다.
After
GET /products/old-item
HTTP/1.1 404 Not Found
대체 상품이나 카테고리 링크는 제공하되, HTTP 상태는 실제 상태와 맞춘다.
검증
curl -I https://example.com/products/old-itemSearch Console URL Inspection에서 마지막 crawl 상태와 indexing allowed 여부를 확인한다. URL Inspection은 indexed version과 live test를 구분해 보여주며, “URL is on Google”도 실제 검색 노출을 보장하지는 않는다.Search Console
Rendering: JavaScript 이후에도 핵심 콘텐츠가 보이는가
현대 웹은 초기 HTML만으로 페이지가 완성되지 않는 경우가 많다. Google은 JavaScript 페이지를 crawling, rendering, indexing 세 단계로 처리하며, Googlebot이 HTML 링크를 파싱하고 렌더링 큐에 넣은 뒤 headless Chromium으로 JavaScript를 실행한다고 설명한다.Google 공식
문제는 “Google은 JavaScript를 실행하니까 괜찮다”로 끝나지 않는다는 점이다. 렌더링은 리소스를 쓰고, 모든 봇이 JavaScript를 실행하는 것도 아니다. 핵심 본문과 주요 링크가 JavaScript 실행 뒤에만 생긴다면 discovery와 indexing이 불안정해진다.
CSR / SSR / SSG를 SEO 관점에서 보기
| 방식 | 장점 | SEO 리스크 |
|---|---|---|
| CSR | 앱처럼 유연하게 동작한다. | 초기 HTML이 비어 있으면 렌더링 의존도가 커진다. |
| SSR | 요청 시점에 완성 HTML을 제공한다. | 서버 비용, 캐싱, hydration 오류 관리가 필요하다. |
| SSG | 빠르고 안정적인 정적 HTML을 제공한다. | 실시간 데이터 반영 방식을 별도로 설계해야 한다. |
Google도 server-side rendering 또는 pre-rendering이 사용자와 crawler 모두에게 좋은 아이디어라고 설명한다.Google 공식
Before / After: 핵심 본문이 JS 이후에만 생기는 경우
Before
<body>
  <div id="root"></div>
  <script src="/app.js"></script>
</body>
문제
초기 HTML에 제목, 본문, 내부 링크가 없다. Google이 렌더링 후 콘텐츠를 볼 수는 있지만, rendering queue와 JavaScript 실행 성공에 의존한다.
After
<body>
  <main>
    <h1>JavaScript SEO 체크리스트</h1>
    <p>이 글은 CSR 환경에서 검색엔진이 콘텐츠를 발견하도록 만드는 방법을 설명합니다.</p>
    <a href="/seo/canonical">canonical 설정 가이드</a>
  </main>
  <script src="/app.js" defer></script>
</body>
검증
curl -s https://example.com/page로 초기 HTML에 핵심 본문이 있는지 본다.- Chrome DevTools에서 View Source와 Elements를 비교한다.
- URL Inspection의 rendered HTML과 screenshot을 확인한다.Search Console
- Rich Results Test로 structured data가 렌더링 후 실제로 보이는지 확인한다.
Indexing: 검색엔진이 문서를 이해하고 대표 URL을 고르는 단계
Indexing은 가져온 페이지를 분석해 Google index에 저장할지 판단하는 단계다. Google은 이 단계에서 텍스트, 이미지, 비디오, <title>, alt 속성 등을 분석하고, 중복 문서라면 canonical을 선택한다고 설명한다.Google 공식
여기서 많이 터지는 문제가 canonical이다. canonicalization은 같은 콘텐츠가 여러 URL에서 보일 때 대표 URL을 고르는 과정이다. Google은 rel="canonical", redirect, sitemap 포함 여부, HTTPS 여부 같은 신호를 참고하지만, 사이트가 선언한 canonical을 항상 따르는 것은 아니라고 설명한다.Google 공식
canonical, redirect, noindex는 다르다
| 도구 | 목적 | 잘못 쓰는 예 |
|---|---|---|
| canonical | 중복·유사 페이지 묶음에서 대표 URL 선호를 전달한다. | 완전히 이동한 URL을 canonical만 바꿔 처리한다. |
| redirect | 사용자와 crawler를 실제 새 URL로 보낸다. | 필터 URL을 모두 홈으로 redirect한다. |
| noindex | 페이지를 인덱스에서 제외하도록 지시한다. | production 템플릿에 staging noindex가 남는다. |
| robots.txt | crawler 접근을 제어한다. | 비공개 페이지를 숨기는 보안 장치로 쓴다. |
self-referencing canonical은 “이 URL이 이 콘텐츠의 대표 URL”이라는 일관된 신호를 준다. pagination, query parameter, slash 유무, http/https, www/non-www가 섞이는 사이트에서는 이 신호가 특히 중요하다.
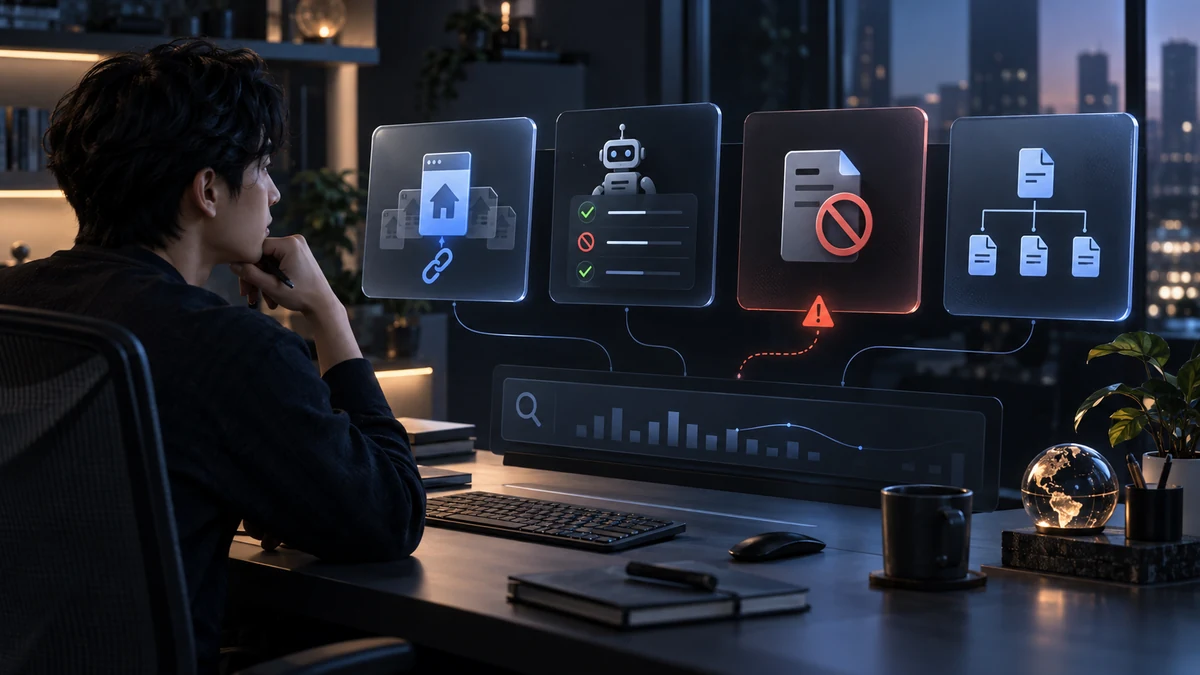
robots.txt와 sitemap.xml: 접근 제어와 발견 보조를 분리한다
robots.txt는 crawler traffic을 관리하는 파일이지 웹페이지를 Google에서 숨기는 보안 장치가 아니다. Google은 robots.txt가 페이지를 Google에서 완전히 숨기는 메커니즘이 아니며, 외부 링크로 발견된 disallow URL은 URL만 검색결과에 나타날 수 있다고 설명한다.Google 공식
User-agent: *
Disallow: /internal-search/
Disallow: /tmp/

Sitemap: https://example.com/sitemap.xml
민감 경로를 숨기려고 다음처럼 쓰는 것은 좋지 않다.
Disallow: /secret-admin-2026/
Disallow: /private-customer-export/
robots.txt는 공개 파일이다. 민감 정보는 인증, 권한, 네트워크 제어, 비공개 저장소, 적절한 HTTP 상태로 다뤄야 한다.
반대로 sitemap은 검색엔진에 중요 URL과 파일 정보를 제공해 더 효율적으로 크롤링하도록 돕는 파일이다. Google은 큰 사이트, 새 사이트, 외부 링크가 적은 사이트, 이미지·비디오·뉴스 콘텐츠가 많은 사이트에서 sitemap이 특히 유용하다고 설명한다.Google 공식
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://example.com/seo/complete-guide</loc>
    <lastmod>2026-09-24</lastmod>
  </url>
</urlset>
sitemap에는 200 OK, indexable, canonical URL만 넣는다. noindex URL, redirect URL, staging URL, 관리자 URL, 검색 결과 페이지를 넣으면 검색엔진과 운영자 모두에게 잘못된 신호가 된다.
Structured Data: 검색엔진에 의미를 명시적으로 알려준다
Structured data는 페이지의 의미를 표준 형식으로 설명하는 방법이다. Google은 structured data를 페이지와 콘텐츠를 분류하기 위한 표준화된 형식으로 설명하고, Search가 페이지를 이해하는 데 explicit clues를 줄 수 있다고 말한다.Google 공식
Schema.org는 Google, Microsoft, Yandex, Yahoo가 이해할 수 있는 공유 vocabulary를 제공한다.Schema.org
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "SEO 완전 가이드",
  "description": "검색엔진 작동 원리와 실전 SEO 구현·검증 방법",
  "author": {
    "@type": "Person",
    "name": "엄선오"
  },
  "datePublished": "2026-09-24",
  "dateModified": "2026-09-24",
  "mainEntityOfPage": "https://example.com/seo/complete-guide"
}
</script>
주의할 점도 있다. structured data는 사용자에게 보이는 내용과 일치해야 한다. Google은 사용자에게 보이지 않는 정보를 마크업하거나 structured data만 담은 빈 페이지를 만들지 말라고 설명한다.Google 공식
즉 Schema는 “순위 상승 버튼”이 아니다. 의미를 명확히 하고 rich result 자격을 얻을 수 있게 돕는 장치다.
Content SEO: 키워드 반복이 아니라 검색 의도에 답하는 구조
콘텐츠 SEO는 키워드를 많이 넣는 일이 아니다. 사용자가 이 검색어로 어떤 문제를 해결하려 하는지 이해하고, 해당 페이지가 어떤 질문에 답하는지 구조화하는 작업이다.
| 검색어 | 가능한 의도 | 필요한 콘텐츠 |
|---|---|---|
| canonical tag | 개념 학습 | 정의, 작동 원리, 예제 |
| canonical 설정 방법 | 구현 | HTML 코드, CMS별 방법, 검증 절차 |
| canonical vs redirect | 비교 | 차이점, 선택 기준, 실패 사례 |
| canonical 오류 Search Console | 문제 해결 | 원인, 진단, 수정, 재검증 |
Google은 people-first content를 강조하며, SEO도 people-first content에 적용될 때 도움이 된다고 설명한다.Google 공식
따라서 좋은 콘텐츠는 다음 질문에 답한다.
- 이것은 무엇인가?
- 왜 필요한가?
- 내부적으로 어떻게 작동하는가?
- 잘못 구현하면 어떤 문제가 생기는가?
- 실제 코드나 설정은 어떻게 생겼는가?
- 적용 후 무엇으로 검증하는가?
- 어떤 오해가 있는가?
Title, description, heading은 각각 역할이 다르다
<title>은 검색결과 title link 후보이자 브라우저 탭 제목이다. H1은 페이지 본문 안에서 독자가 보는 최상위 제목이다. 둘은 같아도 되지만 반드시 같을 필요는 없다. 중요한 것은 둘 다 페이지의 핵심 주제를 정확히 설명해야 한다는 점이다.
<title>SEO 완전 가이드: 검색엔진 작동 원리와 실전 체크리스트</title>
<meta name="description" content="Discovery, Crawling, Rendering, Indexing, Ranking 흐름을 기준으로 SEO를 구현하고 검증하는 실전 가이드입니다.">
<h1>SEO 완전 가이드</h1>
meta description은 snippet 후보가 될 수 있지만 항상 그대로 표시되지는 않는다. Google은 snippet이 주로 페이지 콘텐츠에서 자동 생성되며, meta description이 더 정확한 설명이라고 판단될 때 사용할 수 있다고 설명한다.Google 공식
heading은 디자인용 글자 크기가 아니라 문서의 정보 구조다. WHATWG HTML 문서는 div를 마지막 수단으로 보고, 더 적절한 semantic element가 있으면 그것을 쓰라고 권장한다.HTML 표준
이미지 SEO: alt는 검색과 접근성을 함께 돕는다
이미지 SEO는 파일명과 alt만 넣는 작업이 아니다. 검색엔진이 이미지를 발견할 수 있어야 하고, 이미지가 어떤 정보를 전달하는지 페이지 맥락과 함께 이해할 수 있어야 한다.
W3C WAI는 이미지 목적에 따라 대체 텍스트를 다르게 제공하라고 설명한다. 정보 전달 이미지는 핵심 정보를 설명하고, 장식 이미지는 빈 alt를 사용할 수 있으며, 버튼이나 링크 이미지는 기능을 설명해야 한다.W3C WAI
<figure>
  <img
    src="/images/googlebot-rendering-flow.png"
    alt="Googlebot이 URL을 크롤링한 뒤 렌더링 큐에서 JavaScript를 실행하고 렌더링된 HTML을 인덱싱하는 흐름도"
    width="1200"
    height="675"
    loading="lazy">
  <figcaption>Googlebot의 crawling, rendering, indexing 흐름.</figcaption>
</figure>
실무에서는 다음을 확인한다.
- 중요한 이미지는 robots.txt로 막지 않는다.
width와height를 넣어 layout shift를 줄인다.- 정보 전달 이미지에는 의미 있는 alt를 쓴다.
- 본문 이미지에는 figcaption으로 맥락을 준다.
- cover, OG image, Article JSON-LD image가 서로 모순되지 않게 한다.
Core Web Vitals: 성능은 SEO 이전에 사용자 경험이다
Core Web Vitals는 사용자 경험을 대표하는 지표다. web.dev는 현재 Core Web Vitals를 LCP, INP, CLS로 설명하고, 좋은 사용자 경험 목표를 LCP 2.5초 이하, INP 200ms 이하, CLS 0.1 이하로 제시한다.web.dev
| 지표 | 의미 | 좋은 기준 |
|---|---|---|
| LCP | 주요 콘텐츠가 보이는 속도 | 2.5초 이하 |
| INP | 사용자 입력에 반응하는 속도 | 200ms 이하 |
| CLS | 레이아웃이 흔들리는 정도 | 0.1 이하 |
Search Console Core Web Vitals report는 실제 사용자 데이터, 즉 field data를 기반으로 URL 그룹 단위 상태를 보여준다.Search Console
다만 “Core Web Vitals 점수가 좋으면 무조건 상위 노출된다”는 말은 틀리다. Google은 ranking systems가 많은 factor와 signal을 사용한다고 설명한다.Google 공식 성능은 중요한 사용자 경험 신호이지만, 검색 의도와 콘텐츠 품질을 대체하지 않는다.
Search Console로 무엇을 검증해야 하나
Search Console은 Google Search에서 사이트가 어떻게 crawl, index, serve되는지 이해하고 개선하는 도구다.Google 공식
가장 많이 쓰는 검증 흐름은 다음이다.
| 도구 | 확인하는 것 | 착각하면 안 되는 것 |
|---|---|---|
| URL Inspection | 특정 URL의 index status, crawl, canonical, rendered HTML | 실제 순위나 트래픽을 보장하지 않는다. |
| Performance report | impressions, clicks, CTR, average position | 전환이나 만족도를 직접 말하지 않는다. |
| Core Web Vitals | 실제 사용자 기반 LCP, INP, CLS 상태 | 모든 URL의 세부 성능을 보여주는 것은 아니다. |
| Enhancements | structured data와 rich result 관련 문제 | 오류 없음이 rich result 노출 보장은 아니다. |
배포 후에는 최소한 다음을 확인한다.
curl -I https://example.com/seo/complete-guide
curl -s https://example.com/robots.txt
curl -s https://example.com/sitemap.xml
curl -s https://example.com/seo/complete-guide | grep -Ei "<title>|canonical|robots"
서버 로그를 볼 수 있다면 Googlebot 요청, 4xx/5xx, redirect chain, crawl frequency도 함께 본다.
SEO 성과 지표는 순위 하나로 보지 않는다
검색 성과를 “몇 위인가”로만 보면 원인 분석이 어렵다. 같은 평균 순위라도 노출이 늘었는지, 클릭률이 떨어졌는지, 브랜드 검색만 늘었는지, 특정 landing page가 전환을 만들었는지가 다르다.
| KPI | 의미 | 의미하지 않는 것 |
|---|---|---|
| Impressions | 검색결과에 보인 횟수 | 사용자가 읽었다는 뜻은 아니다. |
| Clicks | 검색결과에서 클릭된 횟수 | 콘텐츠 만족이나 전환을 보장하지 않는다. |
| CTR | 노출 대비 클릭률 | 낮다고 항상 나쁜 것은 아니다. SERP 기능 영향이 크다. |
| Average position | 평균 게재 순위 | 모든 사용자에게 같은 위치였다는 뜻은 아니다. |
| Indexed pages | 인덱스에 들어간 URL 수 | 많을수록 좋은 것이 아니다. |
| Organic sessions | 자연검색 방문 | 검색 의도와 landing page 품질을 분리해서 봐야 한다. |
| Conversion | 가입, 문의, 구매, 구독 등 행동 | SEO만의 결과가 아니라 제품·가격·UX의 합이다. |
실무 보고서는 query → landing page → impressions/clicks/CTR/position → engagement/conversion을 연결해서 본다.
SEO 미신과 오해 검증
meta keywords는 중요한가?
아니다. Google은 web ranking에서 keywords meta tag를 사용하지 않는다고 공식적으로 밝혔다.Google 공식 내부 검색이나 CMS 태깅 용도로 쓰는 것은 별개지만, Google SEO 목적으로는 우선순위가 아니다.
AI로 쓴 콘텐츠는 무조건 패널티를 받나?
아니다. Google은 콘텐츠 생산 방식보다 품질을 본다고 설명한다. 문제는 AI 자체가 아니라, 검색 순위 조작을 주목적으로 자동화 콘텐츠를 만드는 행위다.Google 공식 Google spam policies도 검색 시스템이나 생성형 AI 응답을 조작하려는 spam 행위를 다룬다.Google 공식
글이 길수록 SEO에 좋은가?
부분적으로만 맞다. 긴 글은 더 많은 하위 질문에 답할 수 있지만, 길이 자체가 품질은 아니다. 얇은 문단을 길게 늘리는 것보다 검색 의도에 필요한 정의, 원리, 예제, 검증 방법을 채우는 편이 낫다.
모든 페이지에 Schema를 넣으면 순위가 오르나?
아니다. structured data는 의미를 명시하고 rich result eligibility를 도울 수 있지만, 순위 상승 보증 수단이 아니다. 사용자에게 보이지 않는 정보나 페이지와 맞지 않는 마크업은 오히려 문제다.Google 공식
도메인 권위는 Google 공식 metric인가?
SEO 도구의 Domain Authority, Domain Rating 같은 점수는 Google 공식 metric이 아니다. Google은 link analysis와 PageRank 같은 systems를 설명하지만, 외부 SEO 도구의 단일 도메인 점수를 Google ranking factor처럼 취급하면 안 된다.Google 공식
보안과 운영 사이드이펙트
SEO 설정은 보안과 별개가 아니다. staging 사이트가 인덱싱되거나, 관리자 URL이 sitemap에 들어가거나, 개인정보가 query parameter에 섞이면 검색 노출 문제가 아니라 운영 사고다.
배포 전에는 다음을 자동화해두는 편이 좋다.
# production HTML에 noindex가 남아 있으면 실패
curl -s https://example.com/ | grep -i "noindex" && exit 1

# sitemap에 staging URL이 있으면 실패
curl -s https://example.com/sitemap.xml | grep -i "staging" && exit 1

# sitemap에 관리자·preview·api 경로가 있으면 실패
curl -s https://example.com/sitemap.xml | grep -Ei "/admin|/preview|/api" && exit 1
특히 robots.txt에 민감 경로를 적어 “숨겼다”고 생각하면 안 된다. 그 파일은 누구나 볼 수 있다. staging은 인증이나 IP 제한으로 막고, 관리자 경로는 sitemap과 내부 공개 링크에서 제외하고, 개인정보는 URL에 넣지 않는다.
개발자 체크리스트
- 핵심 페이지가
<a href>내부 링크로 도달 가능한가? - HTTP status가 실제 페이지 상태와 맞는가?
- redirect chain이 길지 않은가?
- canonical이 indexable 대표 URL을 가리키는가?
- production에 noindex가 남아 있지 않은가?
- robots.txt가 필수 CSS/JS/이미지를 막지 않는가?
- sitemap에는 200 OK + indexable + canonical URL만 있는가?
- 초기 HTML 또는 rendered HTML에 핵심 콘텐츠가 있는가?
- structured data가 visible content와 일치하는가?
- LCP, INP, CLS 병목을 확인했는가?
- staging, admin, preview, API endpoint가 검색 노출되지 않는가?
콘텐츠 작성자 체크리스트
- 독자가 이 검색어로 해결하려는 문제를 한 문장으로 말할 수 있는가?
- 핵심 용어를 초반에 정확히 정의했는가?
- 각 섹션이 “무엇 → 왜 → 어떻게 → 검증” 흐름을 갖는가?
- 중요한 주장 옆에 공식 또는 신뢰 출처 태그가 있는가?
- 예제가 실제 개발자가 복사해 이해할 수 있는 수준인가?
- 이미지가 장식이 아니라 본문 이해를 돕는가?
- FAQ가 검색 의도와 실제 독자 질문을 반영하는가?
- GEO/AEO 후속 글과 연결될 구조화 정보, 출처, 질문형 답변을 남겼는가?
SEO에서 GEO/AEO로 이어지는 지점
SEO는 GEO와 AEO의 대체재가 아니다. 하지만 좋은 SEO는 두 영역의 토대가 된다.
GEO 논문은 generative engine이 전통 검색엔진처럼 선형 순위 목록을 보여주지 않고, 여러 출처를 종합해 답변과 citation을 만들기 때문에 visibility metric도 달라져야 한다고 설명한다.GEO 논문 OpenAI도 ChatGPT search가 웹 소스 링크와 Sources sidebar를 제공한다고 설명한다.OpenAI 공식
SEO에서 GEO/AEO로 이어지는 공통 기반은 다음이다.
| SEO 요소 | GEO/AEO와 연결되는 이유 |
|---|---|
| crawlable/indexable public page | AI 검색도 공개 웹 또는 검색 인덱스를 출처 후보로 쓰는 경우가 많다. |
| 명확한 heading | passage 단위 추출과 답변 생성에 유리하다. |
| structured data | entity와 page meaning을 명시한다. |
| 출처와 근거 | citation-worthy content가 되기 쉽다. |
| FAQ와 직답형 문단 | AEO에서 질문-답변 단위로 추출되기 쉽다. |
다만 “이렇게 하면 AI 검색에 반드시 인용된다”고 말하면 과장이다. 플랫폼별 retrieval, ranking, citation selection은 공개 범위가 제한적이고 빠르게 변한다.
오늘 적용할 1가지
오늘 하나만 한다면 Search Console URL Inspection에서 대표 글 하나를 고르고 다음 네 가지를 확인한다.
- Google이 URL을 어떻게 발견했는가.
- crawl allowed와 indexing allowed가 모두 Yes인가.
- user-declared canonical과 Google-selected canonical이 같은가.
- rendered HTML에 H1, 핵심 본문, 내부 링크, 이미지 alt가 실제로 보이는가.
이 네 가지가 맞지 않으면 글을 더 쓰기 전에 검색 시스템의 입구부터 고쳐야 한다.
자주 묻는 질문
SEO는 개발자가 해야 하나, 콘텐츠 작성자가 해야 하나?
둘 다 해야 한다. 개발자는 HTTP 상태, rendering, canonical, robots, sitemap, structured data, 성능, 배포 안전장치를 책임진다. 콘텐츠 작성자는 검색 의도, 정보 구조, 근거, 예제, 업데이트, FAQ를 책임진다. 어느 한쪽만으로는 안정적인 SEO가 되기 어렵다.
robots.txt로 페이지를 막으면 검색에서 사라지나?
항상 그렇지 않다. robots.txt는 crawler 접근을 제어할 뿐, Google에서 웹페이지를 완전히 숨기는 보안 장치가 아니다. 외부 링크로 발견된 disallow URL은 URL 자체가 검색결과에 나타날 수 있다.Google 공식
canonical을 넣으면 Google이 반드시 그 URL을 대표로 쓰나?
아니다. canonical은 강한 힌트지만 최종 선택은 Google이 한다. Google은 redirect, sitemap, HTTPS, rel="canonical" 등 여러 신호를 종합해 canonical URL을 선택한다.Google 공식
AI 글은 SEO에 불리한가?
AI로 작성했다는 사실만으로 불리하다고 단정할 수 없다. Google은 콘텐츠가 어떻게 생산됐는지보다 original, high-quality, people-first content인지에 초점을 둔다고 설명한다. 문제는 검색 순위 조작을 위한 대량 자동화 콘텐츠다.Google 공식
Core Web Vitals만 좋으면 검색 순위가 오르나?
아니다. LCP, INP, CLS는 중요한 사용자 경험 지표지만 ranking은 많은 신호의 조합이다. 성능 개선은 독자 경험과 전환에도 중요하므로 해야 하지만, 콘텐츠 품질과 검색 의도 충족을 대신하지는 못한다.web.dev
이번 글을 쓰며 파이프라인에 남길 점
SEO 글은 특히 “검색엔진이 어떻게 작동한다”는 단정이 쉽게 과장된다. 그래서 공식 문서로 확인된 단계와 실무 추정을 분리해야 한다. seonoh.dev 글에서도 앞으로 검색·AI 검색 주제는 숫자 각주 대신 문장 옆 source-tag를 붙이고, Search Console·렌더링·보안 사이드이펙트까지 함께 검수하는 방식으로 유지한다.
또 하나는 이미지다. SEO처럼 추상적인 주제일수록 의미 없는 사무실 컷이나 가짜 대시보드가 나오기 쉽다. 그래서 이번 글의 이미지는 “파이프라인”, “크롤링/렌더링”, “canonical/robots/sitemap”, “콘텐츠 구조”, “측정/보안”처럼 글의 핵심 단계별 역할을 나눠 생성한다.
참고 자료
- SEO Starter Guide — Google Search Central
- In-depth guide to how Google Search works — Google Search Central
- Understand JavaScript SEO basics — Google Search Central
- Introduction to robots.txt — Google Search Central
- What is canonicalization — Google Search Central
- Learn about sitemaps — Google Search Central
- Introduction to structured data markup — Google Search Central
- Control your snippets in search results — Google Search Central
- Creating helpful, reliable, people-first content — Google Search Central
- Core Web Vitals report — Search Console Help
- Web Vitals — web.dev
- GEO: Generative Engine Optimization — arXiv
기준 시점 2026년 9월 24일 확인. 이 글은 Google Search Central, Search Console 도움말, Schema.org, W3C/WAI, web.dev, GEO 논문, OpenAI 공식 문서를 대조해 작성했다. 검색 순위 알고리즘의 비공개 가중치는 단정하지 않았고, 공식 문서에서 확인되는 처리 단계와 실무 적용 해석을 구분해 적었다.