프롬프트 캐싱은 에이전트 비용 절감 기능이 아니라 운영 계측이다
OpenAI가 GPT-6용 prompt caching dashboard와 diagnostics를 공개하면서 긴 에이전트 운영의 비용 문제가 코드 문제가 아니라 관측·프롬프트 구조 문제로 바뀌었다. 캐시 가능한 고정층, 자주 바뀌는 작업층, 도구 활성화층을 나눠 에이전트 비용과 지연시간을 관리하는 방법을 정리한다.
긴 에이전트를 만들 때 제일 먼저 터지는 문제는 “모델이 똑똑한가”가 아니라 “매번 같은 것을 새로 계산하고 있나”다. OpenAI가 2026년 9월 22일 GPT-6용 prompt caching dashboard와 diagnostics를 공개하면서, 이 문제가 더 이상 감으로 넘길 수 없는 운영 지표가 됐다.OpenAI 공식 이 글의 결론은 간단하다. 프롬프트 캐싱은 할인 기능이 아니라, 긴 AI 에이전트의 프롬프트 구조·도구 관리·비용 경보를 함께 보는 운영 계측이다. 기준 시점은 2026년 9월 25일이다. 오늘 바로 적용할 한 가지는 “에이전트 프롬프트를 고정층과 변경층으로 나누고, 캐시 미스 원인을 로그로 남기는 것”이다.
한 줄 정의
프롬프트 캐싱(prompt caching)은 모델 요청에서 반복되는 앞부분(prefix)을 재사용해 지연시간과 입력 토큰 비용을 줄이는 기술이다. 하지만 에이전트 운영에서는 단순히 “할인받는 기능”이 아니라, 지침·도구 정의·참고 문서·작업 요청이 얼마나 안정적으로 유지되는지 측정하는 관측 지표에 가깝다.
OpenAI는 GPT-6에서 공유 prefix가 30분 안에 재사용될 때 캐시 할인을 제공하고, cached input token에 최대 90% 할인을 줄 수 있다고 설명한다.OpenAI 공식 또 prompt caching dashboard로 hit rate, cached/uncached token composition, 시간별 캐시 성능을 볼 수 있게 했다. 이 말은 “내 에이전트가 왜 비싼지”를 이제 모델 가격표가 아니라 요청 구조에서 찾아야 한다는 뜻이다.
왜 지금 봐야 하나: 에이전트 비용은 채팅 비용과 다르다
짧은 챗봇은 사용자가 질문을 한 번 던지고 답을 받으면 끝난다. 반면 긴 에이전트는 같은 시스템 지침, 같은 도구 목록, 같은 프로젝트 문서, 같은 정책을 들고 여러 번 API를 호출한다. 코드베이스를 읽고, 테스트를 돌리고, 하위 에이전트를 부르고, 결과를 합치고, 검토까지 하면 “같은 앞부분을 계속 붙인 요청”이 자연스럽게 반복된다.
OpenAI는 persistent agents가 코드 리팩터링이나 문서 작성처럼 몇 시간짜리 작업을 수행할 때 동일한 instructions, tool definitions, context를 이어서 사용한다고 설명한다.OpenAI 공식 GitHub도 Copilot이 에디터 보조를 넘어 장시간 multi-step coding session을 수행하는 agentic platform이 되면서 token consumption 기반 과금으로 이동한다고 밝혔다.GitHub 공식
여기서 비용 감각이 달라진다. “이번 요청이 몇 토큰인가”보다 “이 워크플로우에서 반복되는 토큰이 얼마나 새로 처리되는가”가 중요해진다. 같은 20만 토큰 컨텍스트라도 80%가 캐시되면 운영 가능성이 달라지고, 도구 정의 순서가 자주 흔들려 매번 캐시가 깨지면 지연시간과 비용이 동시에 커진다.
프롬프트를 세 층으로 나누면 캐시가 보인다
캐싱을 잘하려면 프롬프트를 긴 문자열 하나로 보지 말고, 성격이 다른 층으로 나눠야 한다.
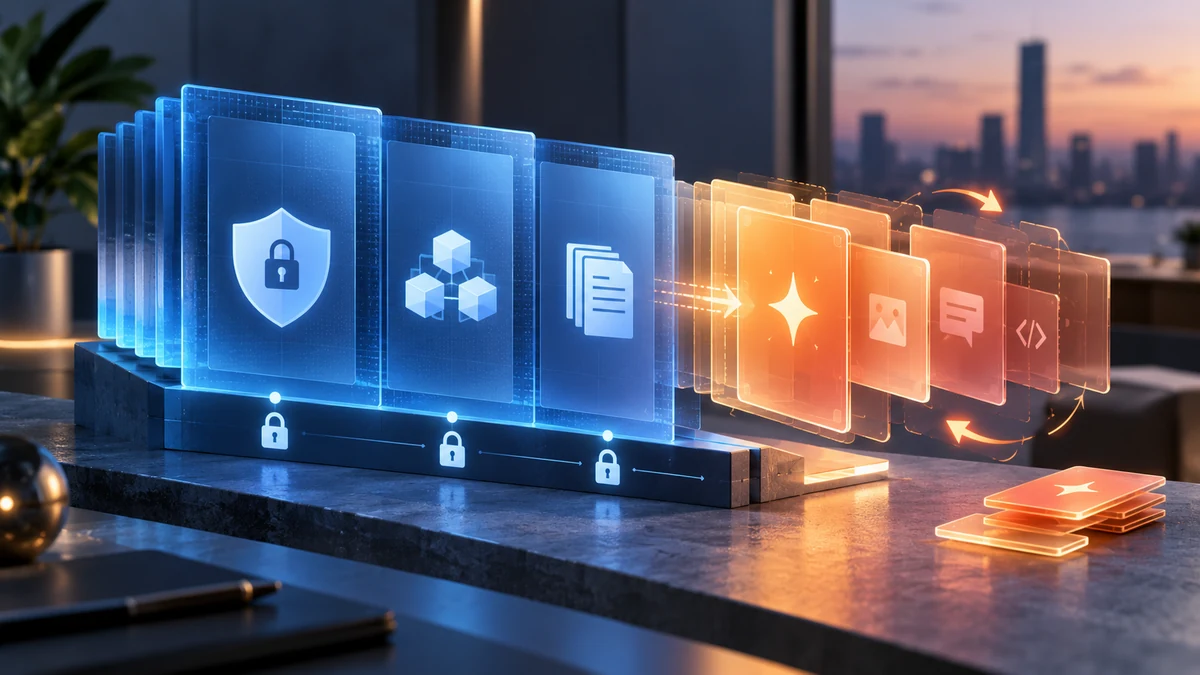
| 층 | 예시 | 캐시 관점 | 운영 원칙 |
|---|---|---|---|
| 고정층 | 시스템 지침, 보안 정책, 출력 규칙, 핵심 도구 schema | 가능하면 오래 유지 | 앞쪽에 두고 순서와 문구를 안정화한다. |
| 준고정층 | 프로젝트 README, API 요약, 최근 배포 정책, 참조 문서 | 작업 단위로 유지 | 작업 시작 전 prewarm하거나 명시적 breakpoint 후보로 둔다. |
| 변경층 | 사용자 요청, 오늘의 로그, 검색 결과, 실패한 테스트 출력 | 자주 uncached | 뒤쪽에 붙이고 짧게 요약해 갱신한다. |
| 도구 활성화층 | 이번 단계에서 실제로 쓸 도구 목록, allowed_tools | 흔들리면 큰 미스 | 정의는 유지하고 호출 가능 범위만 좁힌다. |
핵심은 “덜 중요한 것을 뒤로 보내기”가 아니다. 자주 바뀌는 것을 뒤로 보내고, 자주 바뀌지 않아야 하는 것은 앞에서 안정화하는 것이다. OpenAI도 도구 정의·schema·ordering을 안정적으로 유지하고, 필요 없는 도구를 제거하기보다 allowed_tools나 tool_choice: none으로 호출 가능 범위를 조절하라고 안내한다.OpenAI 공식
캐시 미스는 “느낌”이 아니라 reason code로 잡는다
OpenAI의 diagnostics 예시는 캐시 미스 원인이 tools_changed이고, 재사용 가능했지만 놓친 토큰이 5,629개였다는 형태로 나온다.OpenAI 공식 이 작은 예시가 중요하다. 운영자는 이제 “오늘 좀 느리다”가 아니라 “도구 목록 변경 때문에 5,629토큰을 새로 처리했다”고 말할 수 있다.
운영 로그에는 최소한 다음 네 가지를 남기는 편이 좋다.
cache_hit_rate: 요청 또는 세션 단위 캐시 적중률cached_input_tokens/uncached_input_tokens: 실제 비용을 나누는 입력 토큰 구성cache_miss_reason: tools_changed, model_changed, prefix_changed처럼 원인을 설명하는 값affected_tokens: 캐시가 깨져 새로 계산된 토큰 규모
이 지표가 있으면 회고가 쉬워진다. 비용이 오른 날에 “모델이 비싸졌다”로 끝내지 않고, “새 MCP 도구를 프롬프트 앞쪽에 삽입해 기존 prefix가 깨졌다”, “작업별 동적 지침을 시스템 지침 앞에 붙였다”, “검색 결과 원문을 고정층보다 앞에 넣었다”처럼 수정 가능한 원인으로 바뀐다.
reasoning effort도 캐시를 깨지 않게 조절한다
좋은 운영은 “항상 강한 추론”이 아니다. 단순 분류나 파일명 정리는 낮은 effort로 충분하고, 배포 전 코드리뷰나 장애 분석은 높은 effort가 필요할 수 있다. 문제는 effort를 바꾸는 방식이 cache prefix를 깨면 비용 최적화가 무너진다는 점이다.
OpenAI는 GPT-6에서 request-level reasoning effort를 바꾸지 않고 configuration_update를 뒤에 붙여 중간에 reasoning effort를 조정할 수 있다고 설명한다.OpenAI 공식 Anthropic도 2026년 9월 릴리스 노트에서 mid-conversation system message 안에 tool definition을 추가하거나 변경해, 기존 tools를 편집하지 않고 prompt cache invalidation을 줄이는 beta 기능을 공개했다.Anthropic 공식
서로 다른 회사의 기능이지만 방향은 같다. 긴 세션의 앞부분은 가능하면 안정적으로 유지하고, 바꿔야 하는 것은 뒤쪽에 덧붙여라. 에이전트가 오래 일할수록 “append-only 운영”이 비용과 재현성을 지킨다.
실무 체크리스트: 긴 에이전트 실행 전 12개 점검
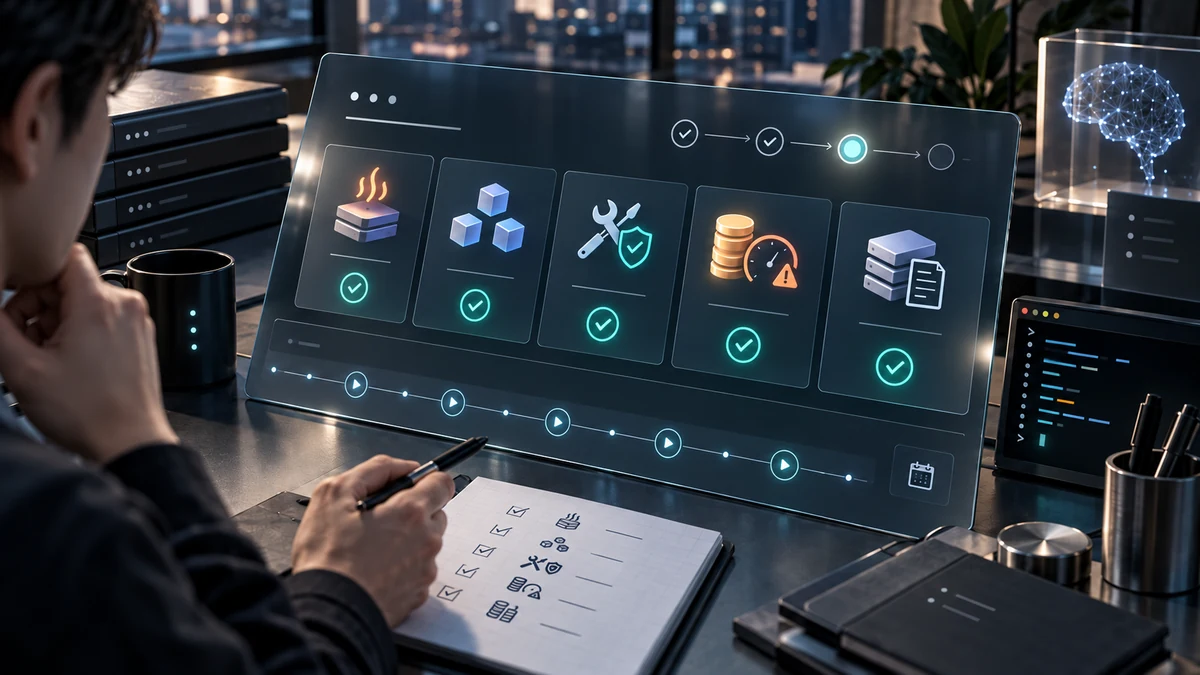
- 시스템 지침, 보안 정책, 출력 schema를 작업 중간에 재작성하지 않는다.
- 도구 정의의 순서와 schema를 안정적으로 유지한다.
- 단계별로 필요 없는 도구는 삭제하지 말고 호출 가능 범위만 좁힌다.
- 검색 결과, 로그, 테스트 출력처럼 자주 바뀌는 데이터는 뒤쪽에 둔다.
- 큰 문서는 원문 전체보다 “고정 요약 + 필요 시 원문 fetch” 구조로 둔다.
- 반복 작업은 시작 전에 shared instructions와 도구 정의를 prewarm한다.
- cache hit rate와 uncached token 비율을 대시보드에서 본다.
- cache miss reason을 로그에 남기고, 배포 전후로 비교한다.
- 모델 변경, 도구 변경, prompt template 변경을 같은 배포에 섞지 않는다.
- reasoning effort 변경은 prefix를 깨지 않는 공식 방식으로 한다.
- 장기 에이전트 작업에는 예산 한도와 중단 조건을 둔다.
- 작업 완료 리뷰에 결과 품질뿐 아니라 토큰 비용과 캐시 적중률을 함께 올린다.
Before / After: 캐시가 깨지는 에이전트 프롬프트
Before
[오늘 검색 결과 20개]
[이번 사용자 요청]
[동적으로 만든 도구 목록]
[시스템 지침]
[프로젝트 정책]
이 구조는 매번 앞부분이 바뀐다. 검색 결과와 사용자 요청이 가장 앞에 있으니, 뒤에 있는 시스템 지침과 프로젝트 정책도 stable prefix가 되기 어렵다. 도구 목록도 매번 새로 만들면 tools_changed 계열 미스가 쉽게 난다.
After
[시스템 지침]
[프로젝트 정책]
[안정적인 도구 정의와 schema]
[작업에 필요한 고정 참고 요약]
--- cache-friendly boundary ---
[이번 사용자 요청]
[오늘 검색 결과 요약]
[이번 단계에서 허용할 도구 범위]
이 구조에서는 앞쪽이 오래 유지된다. 바뀌는 내용은 뒤쪽에 붙고, 도구 정의를 매번 제거하지 않는다. 실무에서는 이 차이가 “히트율 몇 퍼센트”가 아니라, 에이전트 작업을 마음 놓고 병렬로 돌릴 수 있느냐의 차이로 이어진다.
seonoh.dev 자동화에 바로 반영할 점
이번 글을 쓰면서 내 자동화에도 적용할 부분이 분명했다. 블로그 일간 파이프라인은 주제 조사, 초안 작성, 이미지 프롬프트, 편집국 검수, 빌드, 배포 검증처럼 긴 단계로 움직인다. 매번 전체 규칙을 앞에서 흔들면 캐시가 깨지고, 도구 목록과 지침이 뒤섞이면 원인 추적도 어렵다.
앞으로는 다음 세 가지를 남길 만하다.
- 고정 운영 규칙 파일: 글 스타일, source-tag 규칙, 이미지 하드룰은 stable prefix 후보로 둔다.
- 변경 입력 분리: 오늘 조사한 뉴스, 선택한 주제, 이번 글의 출처는 뒤쪽 변경층으로 둔다.
- QA 로그 확장: 빌드 성공만 보지 말고, 긴 에이전트 실행에는 cache hit/miss와 비용 메모를 함께 남긴다.
FAQ
프롬프트 캐싱은 작은 앱에도 필요한가?
요청이 짧고 일회성이라면 우선순위가 낮다. 하지만 시스템 지침, 도구 정의, 문서 컨텍스트가 크고 여러 번 이어지는 앱이라면 작아도 효과가 있다. 특히 내부 운영 봇, 코드리뷰 봇, 리서치 에이전트처럼 같은 규칙을 반복해서 쓰는 경우에는 빨리 봐야 한다.
캐시 히트율 목표는 몇 퍼센트가 적당한가?
정답은 없다. OpenAI가 공개한 사례에서는 Manus가 85%대에서 90% 이상으로 올렸고, Wordsmith는 83%에서 91%로 올렸다고 밝혔다.OpenAI 공식 중요한 것은 남의 숫자를 복사하는 것이 아니라, 내 워크플로우에서 “정상 히트율”을 정하고 떨어졌을 때 원인을 찾는 것이다.
도구가 자주 바뀌는 에이전트는 캐싱과 맞지 않나?
맞지 않는 것이 아니라 설계가 더 필요하다. 도구 정의 자체를 매번 갈아끼우기보다 안정적으로 유지하고, 이번 단계에서 호출 가능한 도구만 제한하는 방식이 낫다. 새 도구를 추가해야 한다면 append-only 방식으로 뒤에 붙일 수 있는지 먼저 본다.
prewarming은 언제 써야 하나?
사용자 요청이 들어온 뒤 긴 공통 컨텍스트를 처음 처리하면 대기시간이 커진다. 제품 시작 시점이나 작업 큐 시작 전에 shared instructions, tool definitions, reference material을 미리 준비할 수 있다면 prewarming 후보가 된다. OpenAI도 known context를 미리 준비해 첫 응답 대기시간에서 처리 비용을 빼는 방식으로 설명한다.OpenAI 공식
캐싱만 잘하면 에이전트 비용 문제가 해결되나?
아니다. 캐싱은 입력 비용과 지연시간을 줄이는 강력한 축이지만, 출력 토큰, 도구 실행 비용, 브라우저/샌드박스 비용, 실패 재시도, 사람 검토 시간은 따로 관리해야 한다. 그래서 캐싱은 비용 최적화의 끝이 아니라 시작점이다.
출처
- OpenAI — Better prompt caching for GPT-6
- OpenAI — Introducing the Agents API
- Anthropic — Claude Platform release notes
- GitHub — Copilot usage-based billing
타깃 유입 키워드
OpenAI prompt caching, GPT-6 prompt caching dashboard, prompt cache diagnostics, 프롬프트 캐싱, 에이전트 비용 최적화, AI agent token cost