EmbeddingGemma 2가 던진 질문: RAG는 이제 텍스트만 찾으면 부족하다
EmbeddingGemma 2는 텍스트·코드·이미지·영상·오디오를 하나의 벡터 공간에 넣는 공개 멀티모달 임베딩 모델이다. 작은 팀이 이 소식을 어떻게 RAG·검색·권한·비용 판단으로 바꿔야 하는지 정리한다.
EmbeddingGemma 2를 오늘 바로 써야 하는 팀은 “챗봇 답변”이 아니라 내 문서·코드·이미지·영상·오디오를 한 번에 찾는 검색/RAG 문제를 가진 팀이다. 기준 시점은 2026년 10월 7일이며, 2026년 10월 6일 공개된 공식 블로그와 모델 카드 기준으로 보면 이 모델의 실무 포인트는 성능 과시보다 로컬에서 돌릴 수 있는 멀티모달 색인 선택지가 생겼다는 데 있다. 공식 발표
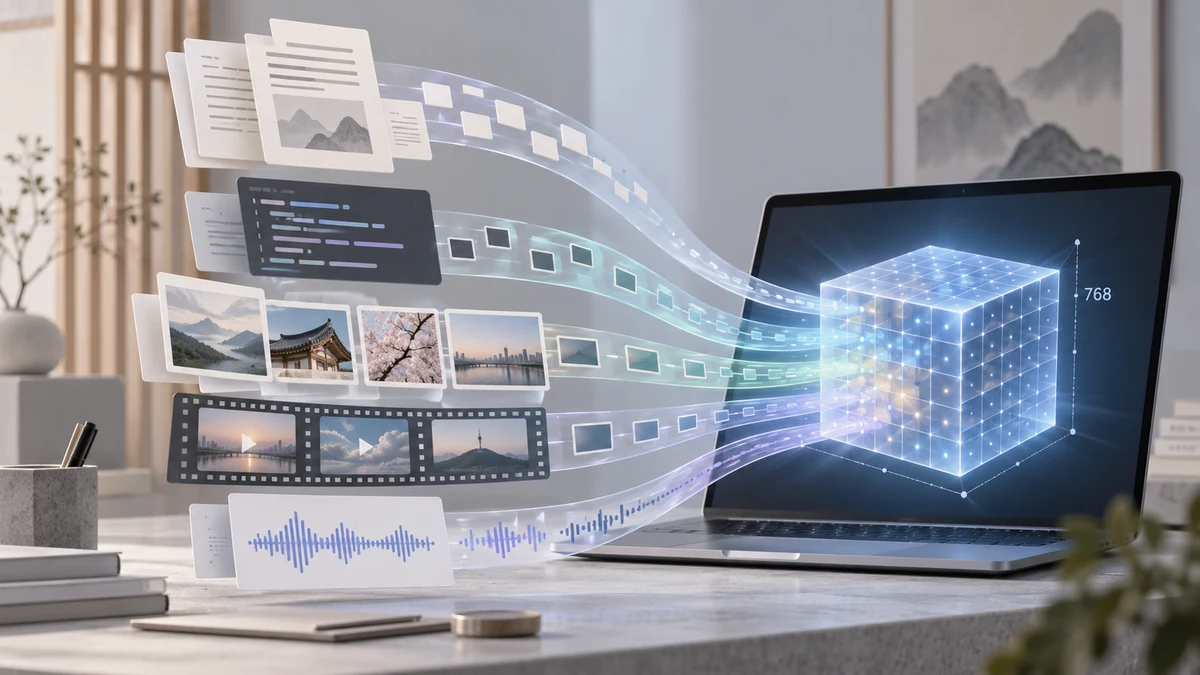
오늘의 독자 질문: 이미지·영상·오디오까지 RAG에 넣어야 할 때, 처음부터 거대한 클라우드 파이프라인이 필요할까
최근 seonoh.dev의 글들은 팀 채널의 @ChatGPT, 에이전트 런타임, 브라우저 자동화처럼 “AI가 행동하는 표면”을 주로 다뤘다. 오늘의 새 기여는 그보다 아래층이다. 에이전트가 행동하기 전에 무엇을 근거로 찾고 기억할지, 특히 텍스트가 아닌 자료까지 다뤄야 할 때 검색 레이어를 어떻게 작게 시작할지 정리한다.
공식 모델 카드와 개발자 가이드는 EmbeddingGemma 2를 “text, code, images, video, and audio”를 하나의 768차원 공간으로 매핑하는 open multimodal embedding model이라고 설명한다. 모델 카드에는 전체 740M 파라미터, 텍스트 270M, 비전 170M, 오디오 300M 인코더 조합이 명시되어 있다. 공식 모델 카드
적용 조건은 분명하다. 회사 내부 문서가 전부 Markdown·PDF 텍스트라면 기존 텍스트 임베딩만으로도 충분할 수 있다. 반대로 고객 상담 녹취, 제품 사진, 교육 영상, 화면 캡처, 코드 조각이 섞여 있고 “이 장면과 비슷한 자료를 찾아줘” 같은 질문이 늘어난다면 멀티모달 임베딩을 검토할 이유가 생긴다.
무엇이 달라졌나: 캡션 변환 없이 같은 검색 공간에 넣는 선택지
기존 멀티모달 검색은 종종 우회로를 썼다. 이미지를 OCR·캡션으로 바꾸고, 오디오는 STT로 바꾸고, 영상은 프레임 캡션으로 바꾼 뒤 텍스트 임베딩에 넣는다. 이 방식은 빠르게 시작하기 좋지만 변환 과정에서 중요한 시각 정보나 소리의 맥락이 빠질 수 있다.
EmbeddingGemma 2의 변화는 이 우회로를 줄이는 데 있다. 개발자 가이드는 이 모델이 text, code, images, video, audio를 shared 768-dimensional vector space로 매핑하며, 필요한 모달리티만 로드할 수 있다고 설명한다. 개발자 가이드
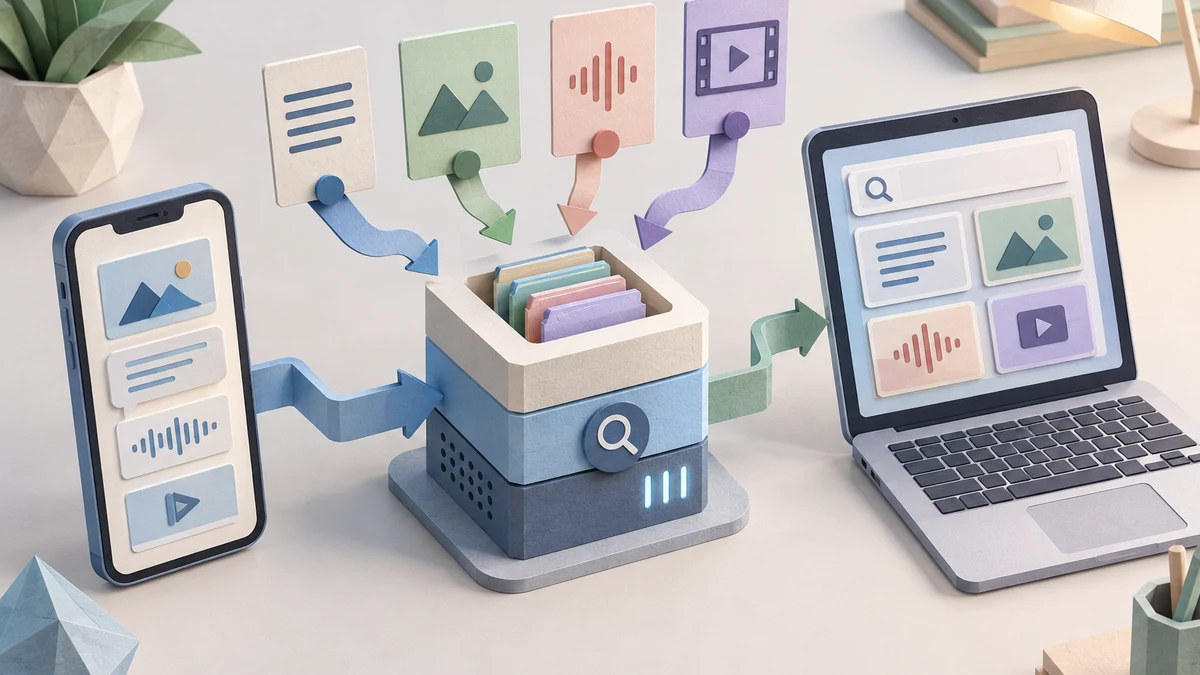
실무적으로는 “한 번에 다 바꾸자”가 아니라 검색 입구를 넓히는 문제다. 예를 들어 사내 디자인 자료를 찾을 때 사용자는 “빨간 CTA가 있는 모바일 화면”이라고 쓸 수도 있고, 참고 이미지를 올릴 수도 있다. 교육 영상에서는 “이 오류 메시지가 나온 부분”을 텍스트로 찾을 수도 있고, 녹음된 메모로 찾을 수도 있다.
왜 오늘 봐야 하나: 공개 모델이라 작은 팀의 실험 비용이 낮다
공식 발표는 EmbeddingGemma 2가 Gemma 4 architecture 기반이며 Apache 2.0 license로 공개됐다고 설명한다. Hugging Face 모델 페이지도 license를 apache-2.0으로 표시하고, DeepMind가 만든 모델이라고 밝힌다. Hugging Face 모델 페이지
이 지점이 중요하다. 멀티모달 RAG는 대기업만 하는 거대한 검색 프로젝트처럼 보이지만, 공개 가중치와 일반 개발 도구가 있으면 먼저 작은 색인으로 검증할 수 있다. 개발자 가이드는 sentence-transformers, Transformers, vLLM, SGLang, MLX, Ollama, LMStudio, LiteRT 같은 실행 경로를 안내한다. 다만 이 목록은 “모든 환경에서 즉시 안정 운영”을 뜻하지 않는다. 각 팀은 지원 버전, 메모리, 속도, 배포 표면을 따로 확인해야 한다.
가장 안전한 첫 실험은 “전체 지식베이스”가 아니다. 자료 형식이 섞여 있고 성공 여부를 눈으로 확인할 수 있는 폴더 하나를 고르는 것이다. 예를 들어 고객 문의 스크린샷 200장, 짧은 튜토리얼 영상 20개, 제품 문서 100개처럼 결과를 사람이 빠르게 판정할 수 있는 묶음이 좋다.
어떻게 시작할까: 세 갈래로 나눠 판단한다
첫째, 텍스트·코드 검색만 필요한가. 모델 카드에 따르면 텍스트와 코드만 쓰는 경우 270M 파라미터 구성을 볼 수 있다. 이 경우 목표는 “기존 텍스트 임베딩보다 좋은가”가 아니라 “로컬 실행, 라이선스, 다국어·코드 검색, 운영 비용을 합쳤을 때 바꿀 이유가 있는가”다.
둘째, 이미지·영상·오디오가 실제 업무 질문에 들어오는가. DeepMind 소개 페이지는 “Search images with a text query”와 “Find a specific moment in a video using a voice memo” 같은 사용 예를 든다. DeepMind 소개 이 예시가 팀의 자료 탐색 방식과 맞는다면 멀티모달 색인이 의미 있다.
셋째, 데이터가 어디에 남아야 하는가. 고객 녹취, 미공개 제품 사진, 내부 화면 캡처처럼 외부 전송이 부담인 자료는 로컬·온디바이스 검색의 이점이 커진다. 반대로 이미 클라우드 저장소와 권한 체계가 잘 정리되어 있고 대용량 배치 색인이 필요하다면 클라우드 파이프라인이 운영상 더 단순할 수 있다.
비용은 모델 크기보다 벡터 차원과 재색인 주기가 좌우한다
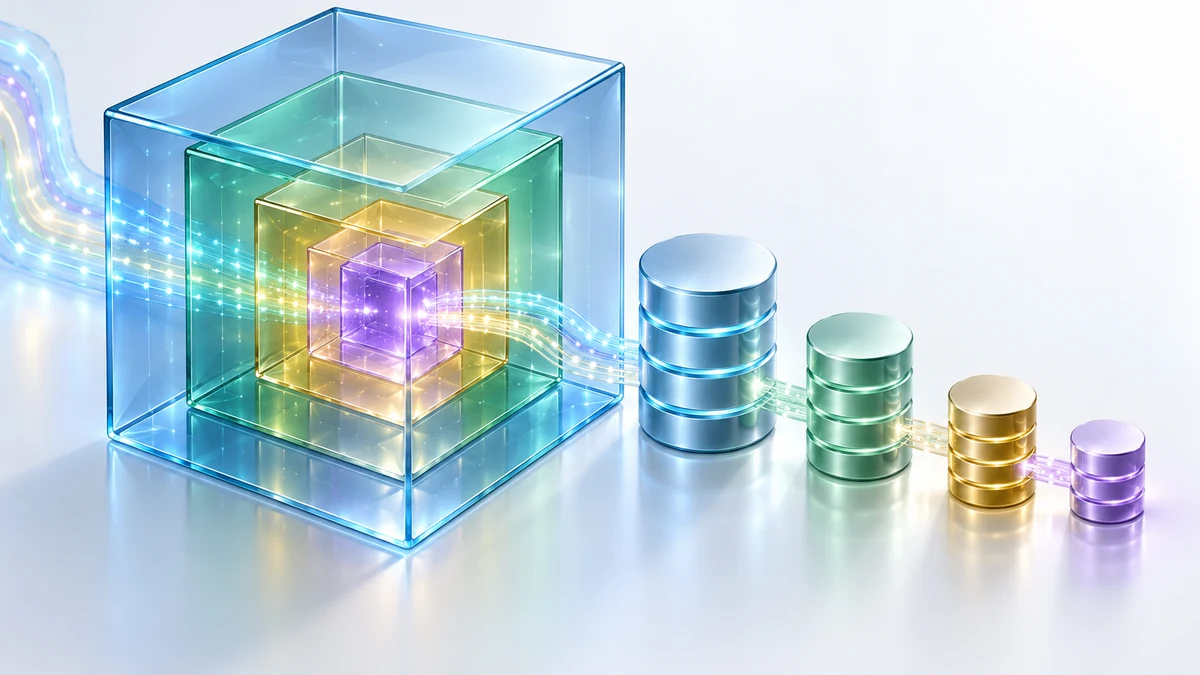
EmbeddingGemma 2를 도입할 때 모델 다운로드 크기만 보면 판단이 빗나간다. 실제 운영 비용은 벡터를 얼마나 많이 저장하는지, 차원을 얼마나 유지하는지, 자료가 바뀔 때 얼마나 자주 다시 색인하는지에서 크게 갈린다.
모델 카드는 Matryoshka Representation Learning을 통해 128d, 256d, 512d, 768d truncated embedding을 지원하고, vector storage costs를 줄일 수 있다고 설명한다. 개발자 가이드는 256차원에서 텍스트·코드의 원래 품질 대부분과 이미지·영상·음성 검색의 약 95%를 유지한다고 소개한다. 이 수치는 공식 문서의 벤치마크 맥락 안에서 봐야 하며, 각 팀의 한국어 문서·이미지·오디오에서는 별도 평가가 필요하다. 개발자 가이드 · MRL
실무 체크는 간단하다. 같은 샘플 100개로 768, 512, 256 차원 색인을 만들고, 팀원이 실제로 던질 질문 30개를 준비한다. 정답 후보가 상위 5개 안에 드는지, 엉뚱한 이미지나 영상이 섞이는지, 한국어 약어·제품명·파일명이 깨지는지 확인한다. 이 평가 없이 “차원을 줄여도 된다”고 말하면 비용 최적화가 아니라 품질 손실을 숨기는 일이 된다.
실패 조건: 임베딩은 답을 보장하지 않는다
EmbeddingGemma 2는 생성 모델이 아니라 입력을 벡터로 바꾸는 모델이다. 모델 카드도 pre-trained embedding model이며 generative model과 달리 post-training alignment, safety tuning, output-level moderation을 거치지 않는다고 설명한다. 따라서 위험한 자료를 “안전하게 설명해 주는 모델”로 착각하면 안 된다. 모델 카드 · 한계
또 하나의 실패 조건은 권한이다. 검색 품질이 좋아질수록 사용자는 더 많은 내부 자료를 한 번에 찾게 된다. 이때 색인 단계에서 권한을 잃어버리면, 원본 시스템에서는 볼 수 없는 이미지·영상·문서가 검색 결과로 튀어나올 수 있다. 로컬 실행은 개인정보 전송을 줄일 수 있지만, 사내 권한 모델을 자동으로 해결하지는 않는다.
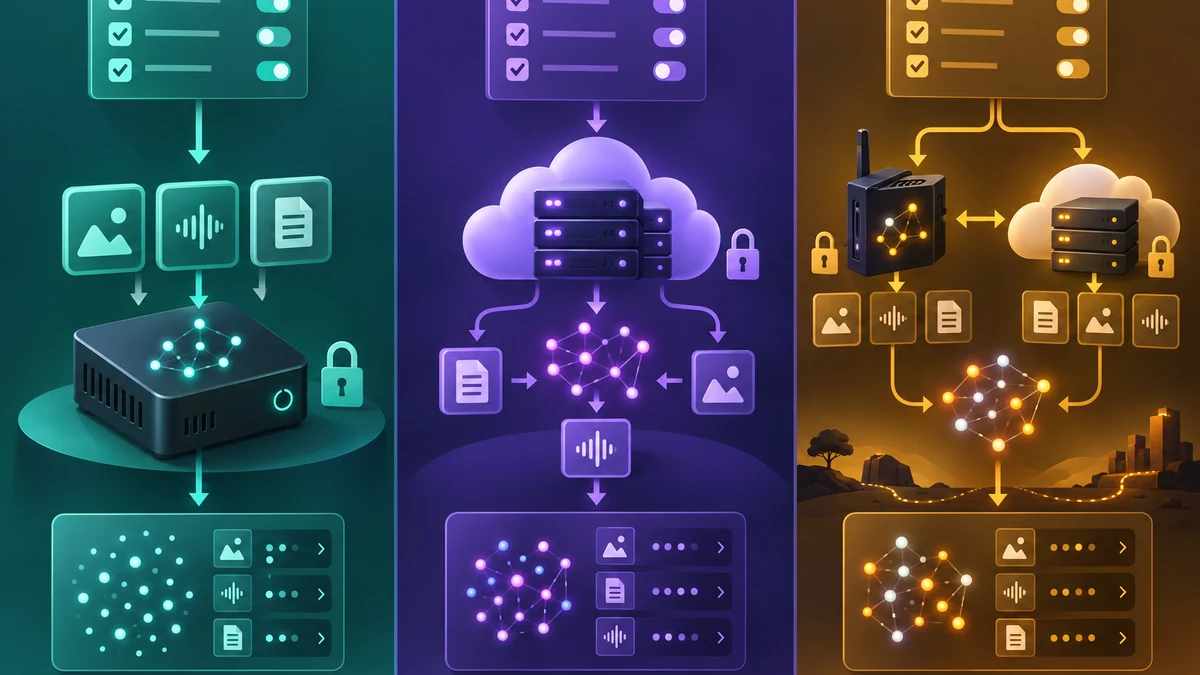
작은 팀의 결론은 이렇다. EmbeddingGemma 2는 “모든 RAG를 교체할 새 정답”이 아니라, 텍스트 밖 자료가 많고 로컬·온디바이스 제약이 있는 팀에게 생긴 새 실험 카드다. 먼저 하나의 업무 폴더에서 검색 정확도·권한·재색인 비용을 재고, 통과하면 그때 문서 전체나 고객 자료 전체로 넓혀도 늦지 않다.
도입 전 5문장 체크리스트
- 우리가 찾고 싶은 자료는 텍스트만이 아니라 이미지·영상·오디오까지 섞여 있는가.
- 사용자가 실제로 던질 질의는 텍스트 검색어뿐 아니라 이미지나 음성 단서도 포함하는가.
- 원본 자료의 접근 권한을 벡터 검색 결과에도 그대로 적용할 수 있는가.
- 768·512·256 차원별로 상위 5개 검색 품질을 눈으로 비교했는가.
- 로컬 실행의 이점이 모델 운영·배포·업데이트 부담보다 큰가.
자주 묻는 질문
기존 텍스트 임베딩을 바로 버려야 하나?
아니다. 내부 자료가 문서와 코드 중심이면 기존 텍스트 임베딩이 더 단순할 수 있다. EmbeddingGemma 2는 이미지·영상·오디오까지 같은 검색 경험에 넣고 싶을 때 우선 검토할 카드다.
한국어 검색에도 바로 믿고 써도 되나?
모델 카드에는 100개 이상 언어 이해와 학습 데이터의 140개 이상 언어 포함이 언급된다. 다만 팀의 실제 한국어 약어, 파일명, 제품명, 음성 품질은 별도 샘플 평가가 필요하다.
온디바이스라는 말은 서버가 전혀 필요 없다는 뜻인가?
항상 그렇지는 않다. 작은 개인 검색이나 프라이버시 중심 기능은 로컬 실행이 유리할 수 있지만, 조직 전체 권한·감사·재색인·공유 검색이 필요하면 서버나 하이브리드 구조가 필요할 수 있다.
에이전트와는 어떤 관계가 있나?
에이전트가 도구를 실행하기 전에 관련 문서, 화면, 녹취, 영상을 찾는 검색 레이어가 필요하다. 멀티모달 임베딩은 에이전트의 행동 능력보다 “무엇을 근거로 볼 것인가”를 넓히는 기술이다.