Claude Haiku 5.5가 싸졌다고 전부 맡기면 안 된다: 에이전트 라우팅표부터 바꿔라
Claude Haiku 5.5는 고빈도·저지연 작업을 겨냥한 가장 빠른 Haiku 계열 모델이다. 가격표보다 중요한 변화는 분류·추출·라우팅을 작은 모델에 맡기고, 브라우저·컴퓨터 실행은 권한 기준으로 승격하는 운영 설계다.
Claude Haiku 5.5를 오늘 봐야 하는 팀은 “가장 똑똑한 모델을 하나 더 고르려는 팀”이 아니라 에이전트 요청을 매일 많이 처리하면서 비용·속도·권한 기준이 흐려진 팀이다. 기준 시점은 2026년 10월 8일이다. Anthropic 문서는 Haiku 5.5를 “classification, extraction, and routing” 같은 고빈도·저지연 작업용으로 설명하고, 기본 가격도 입력 100만 토큰당 0.10달러부터라고 적는다. 이 글의 결론은 단순하다. 작은 모델이 싸졌다면 자동화 범위를 넓히기보다, 먼저 어떤 일을 작은 모델에 맡기고 어떤 일을 큰 모델·사람 승인·샌드박스로 올릴지를 다시 그려야 한다. Anthropic 모델 문서
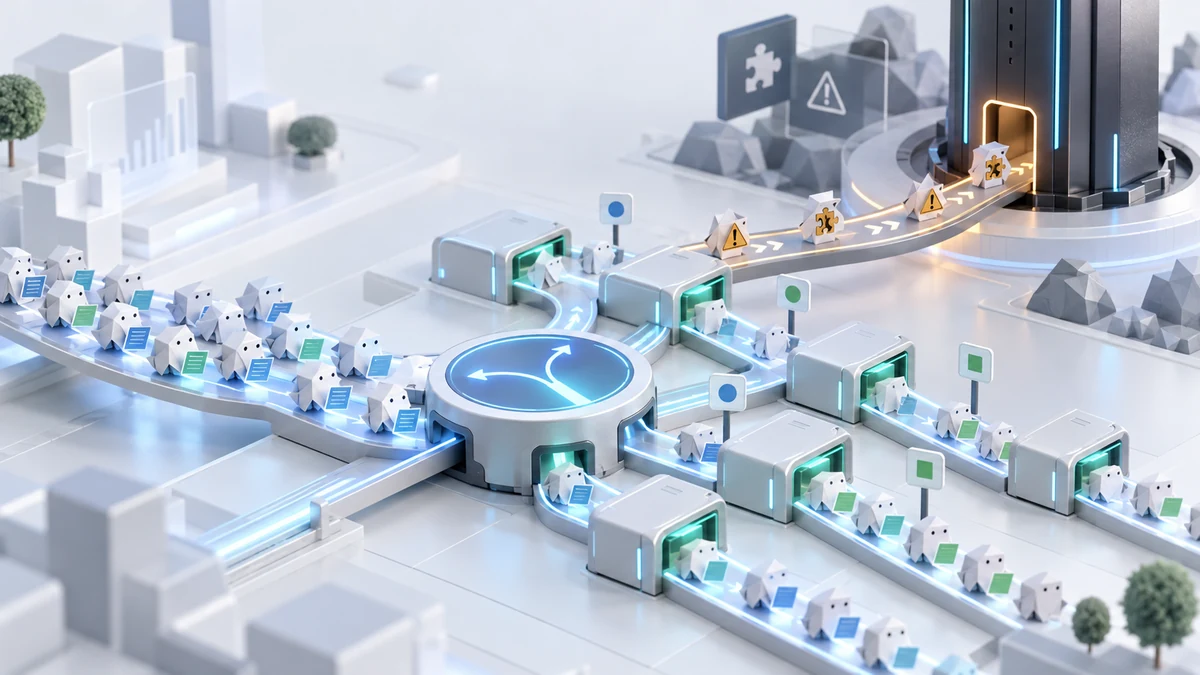
오늘의 독자 질문: 작은 모델이 충분히 좋아지면, 에이전트 운영표는 어떻게 바뀌나
최근 seonoh.dev에서는 멀티모달 RAG, Slack·Teams 안의 ChatGPT, 브라우저 에이전트, decision model을 다뤘다. 오늘의 새 기여는 그 사이의 운영판이다. “큰 모델 하나로 끝내자”도 아니고 “작은 모델이 다 해결한다”도 아니다. Haiku 5.5 같은 빠른 모델이 들어오면, 에이전트 시스템의 기본값은 모델명 선택이 아니라 요청 분류와 승격 조건이 된다.
Anthropic의 모델 개요는 Haiku 5.5를 현 라인업에서 가장 빠른 모델로 분류하고, 설명란에 “high-volume, latency-sensitive tasks such as classification, extraction, and routing”을 둔다. 같은 표에서 Sonnet 5.5는 속도와 지능의 조합, Opus 5.5는 장기 에이전트 코딩과 지식 작업, Fable 5.1은 demanding reasoning으로 구분된다. 모델 비교표 이 구분을 그대로 받아들이면, 실무 질문은 “Haiku가 Sonnet을 이겼나?”가 아니라 “우리 요청 중 Haiku급으로 내려도 되는 것은 무엇인가?”가 된다.
가격표가 아니라 라우팅표를 바꿔야 한다
작은 모델의 가격이 낮아지면 가장 먼저 떠오르는 유혹은 “이제 더 많이 돌리자”다. 하지만 에이전트 운영에서는 호출 수를 늘리는 것보다 호출 목적을 나누는 편이 더 안전하다. 예를 들어 고객 문의 자동화라면 첫 호출은 감정·긴급도·개인정보 포함 여부를 분류한다. 두 번째 호출은 이미 검증된 지식베이스에서 필요한 문단을 뽑는다. 환불·계약·계정 삭제처럼 실제 결과가 큰 일은 큰 모델 또는 사람 승인으로 승격한다.
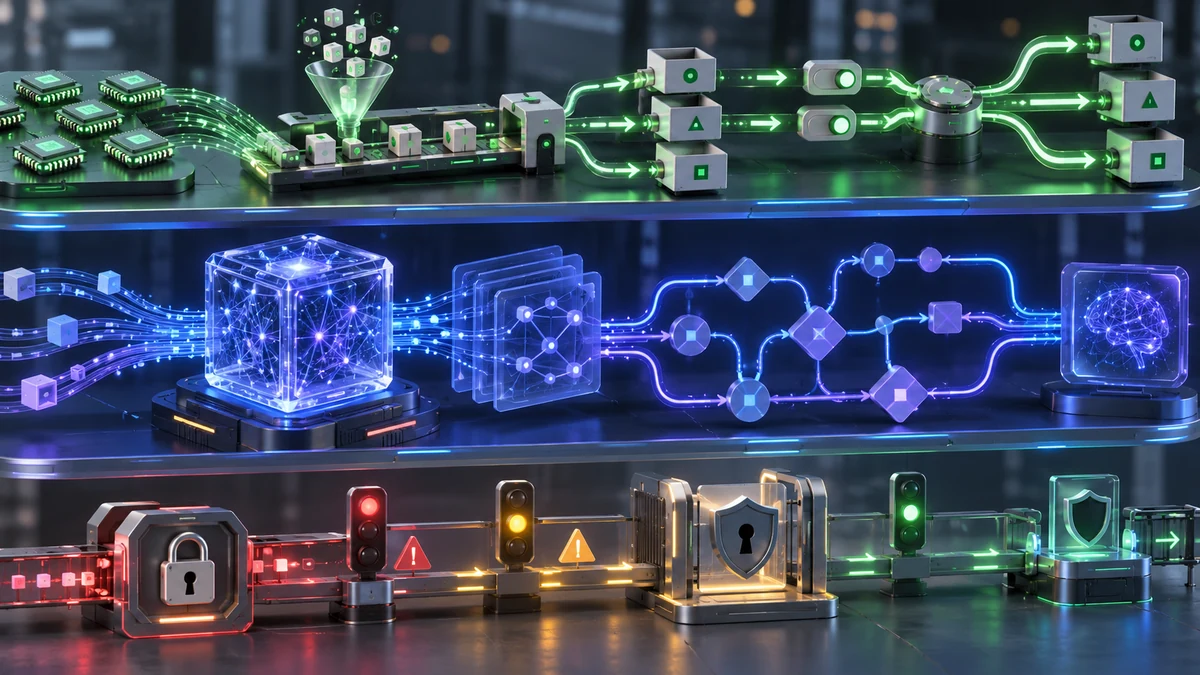
이 구조에서 Haiku 5.5가 맡기 좋은 일은 답변 최종 생성보다 앞단이다. 분류, 요약, 태그, 중복 제거, 검색 쿼리 생성, 쉬운 추출, 다음 모델 선택 같은 작업이다. 반대로 법률·금융 판단, 고객에게 보내는 최종 사과문, 계정 변경, 결제, 외부 서비스 실행은 “싸다”는 이유로 자동 통과시키면 안 된다. 작은 모델은 운영비를 낮추는 부품이지 책임을 없애는 면허가 아니다.
Anthropic 시스템 카드는 Haiku 5.5가 Haiku 4.5보다 여러 영역에서 크게 개선됐고 일부 영역에서는 Sonnet 5.5와 경쟁하거나 넘었다고 설명한다. 동시에 Responsible Scaling Policy 평가에서는 Opus 5보다 전반적으로 덜 강하고 새로운 RSP threshold를 넘지 않는다고 적는다. Haiku 5.5 시스템 카드 그래서 운영 기준은 “작은 모델도 똑똑해졌다”와 “모든 책임 작업에 충분하다”를 분리해야 한다.
브라우저 작업과 데스크톱 작업도 같은 기준으로 나누자
에이전트 비용만 줄여도 운영이 좋아지는 것은 아니다. 모델이 실제 화면을 만지기 시작하면 도구 선택이 더 중요해진다. Anthropic의 browser use 문서는 Claude가 애플리케이션이 실행하는 브라우저에서 웹페이지를 읽고 상호작용하며, 접근성 트리·요소·폼·탭과 스크린샷·좌표를 함께 사용한다고 설명한다. 같은 문서는 웹 안에서 끝나는 작업은 browser use가 더 맞고, 전체 데스크톱이 필요하면 computer use를 쓰라고 구분한다. browser use 문서
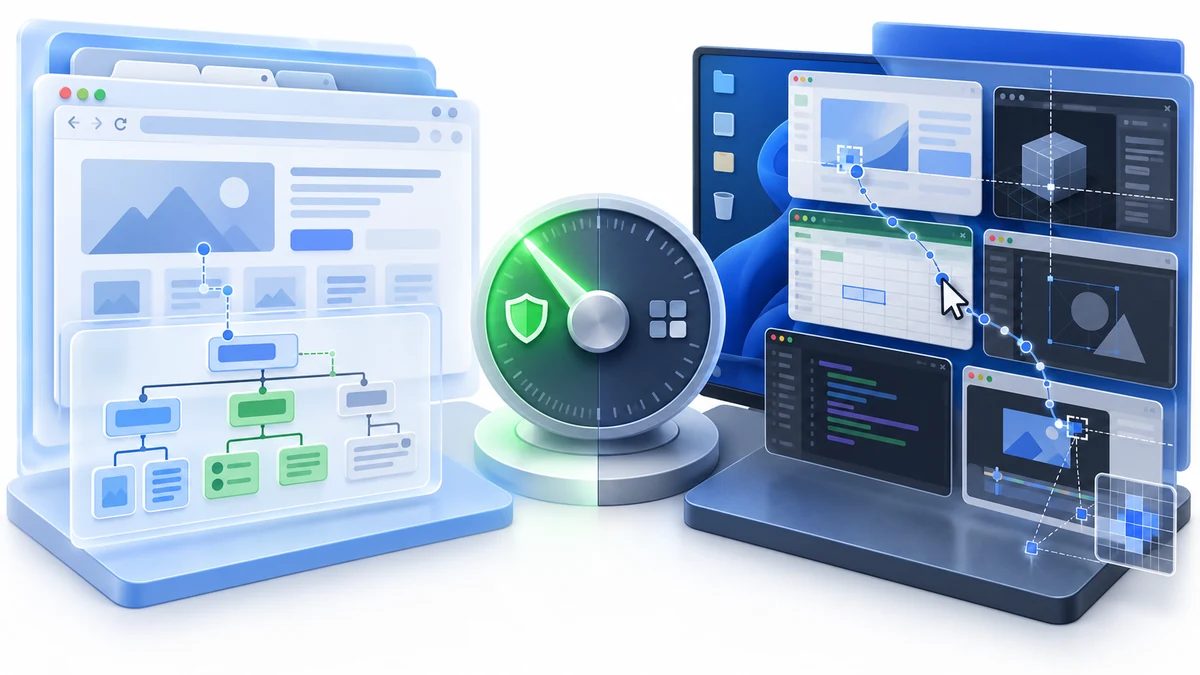
이 구분은 비용 최적화와 비슷하다. 가장 좁은 도구부터 써야 한다. 웹 폼 입력, 문서 읽기, 탭 이동, 표 추출처럼 브라우저 안에서 끝나는 일은 browser use로 제한한다. 레거시 데스크톱 앱, IDE, 파일 탐색기, 여러 앱을 오가는 검증처럼 웹 구조만으로 부족한 일만 computer use로 올린다. 이렇게 해야 실패했을 때 원인이 좁아지고, 로그와 권한 검토도 쉬워진다.
Computer use 문서는 computer_toolset_20260801 하나가 screenshot, left_click, type, zoom 같은 17개 member tool을 제공하며, 애플리케이션이 자기 환경에서 각 호출을 실행한다고 설명한다. 또 인터넷과 상호작용할 때 위험이 커지므로 최소 권한의 가상머신·컨테이너, 민감정보 회피, allowlist, 중요한 결과에 대한 사람 확인을 권한다. computer use 문서
“화면을 본다”는 건 공격 표면도 본다는 뜻이다
브라우저와 데스크톱 도구가 강해질수록 모델은 더 많은 것을 볼 수 있다. 그만큼 웹페이지, 이미지, 문서 안의 지시문도 더 쉽게 들어온다. Computer use 문서는 웹페이지나 이미지에 들어 있는 지시가 사용자의 지시와 충돌해도 Claude가 따를 수 있으므로 민감 데이터와 행동을 격리하라고 경고한다. 같은 문서는 스크린샷 같은 도구 결과를 분류기가 스캔해 잠재적 프롬프트 인젝션을 표시한다고 설명하지만, 그 보호가 모든 사용 사례에 이상적이지 않을 수 있다고도 말한다. 보안 고려사항
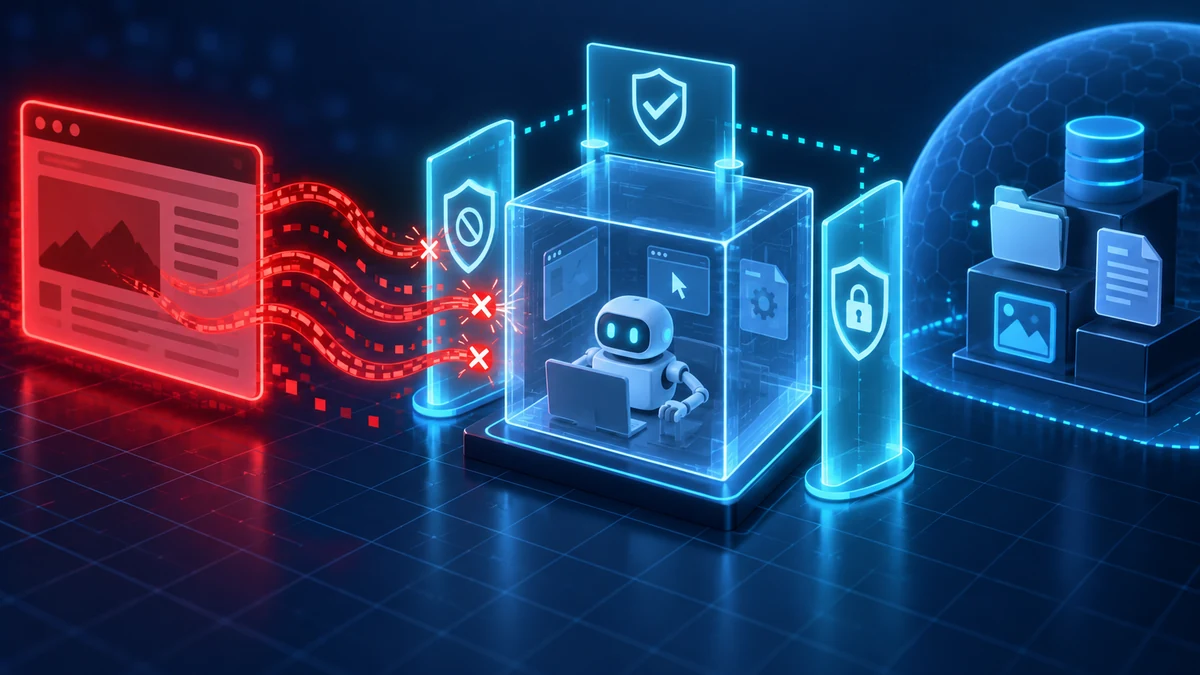
실무에서는 이 말을 운영 체크리스트로 바꿔야 한다. 첫째, 모델이 보는 브라우저 프로필과 사람이 쓰는 브라우저 프로필을 나눈다. 둘째, 읽을 수 있는 폴더와 수정할 수 있는 폴더를 분리한다. 셋째, 외부 결제·삭제·약관 동의·고객 발송처럼 되돌리기 어려운 행동은 작은 모델이 아니라 별도 승인 단계로 보낸다. 넷째, 페이지 안의 문구를 “사용자 명령”으로 취급하지 않는 검사를 둔다.
Agent SDK는 “하네스까지 제품화”되는 신호다
비용·도구·권한을 나누는 작업은 결국 하네스 설계다. Claude Code의 Agent SDK 문서는 Agent SDK가 Claude Code를 Python·TypeScript 애플리케이션 안에서 라이브러리처럼 쓰게 하고, built-in tools, permissions, sessions, hooks, MCP 같은 기능을 제공한다고 설명한다. Agent SDK 문서 이 흐름은 모델 API만 호출하는 시대에서, 실행 루프·세션·권한·도구 연결까지 함께 고르는 시대로 넘어가고 있다는 신호다.
그렇다고 모든 팀이 당장 Agent SDK로 갈아탈 필요는 없다. 이미 자체 큐, 감사 로그, 승인 체계가 있다면 Client SDK로 직접 tool loop를 운영하는 편이 더 명확할 수 있다. 반대로 Claude Code의 파일 읽기·명령 실행·세션·권한 모델을 제품 내부 자동화에 빨리 붙이고 싶다면 Agent SDK가 실험 속도를 높일 수 있다. 기준은 “멋있어 보이는 도구”가 아니라, 우리 팀이 실패했을 때 어떤 로그와 재현 경로를 남길 수 있느냐다.
오늘 바로 바꿀 라우팅 기준
작게 시작하려면 아래 다섯 줄이면 된다.
- 요청을
분류/추출/요약,최종 답변,도구 실행,외부 영향,사람 승인으로 나눈다. 분류/추출/요약과 다음 모델 선택은 Haiku급 빠른 모델 후보로 둔다.- 긴 추론, 모호한 정책 판단, 고객에게 남는 최종 문장은 Sonnet·Opus급 또는 사람 검토로 올린다.
- 웹 안에서 끝나는 실행은 browser use, 데스크톱 전체가 필요한 실행은 computer use로 나눈다.
- 결제·삭제·계약·개인정보·외부 발송은 모델 크기와 무관하게 승인 지점을 둔다.
실패 조건도 분명하다. 요청 라벨이 틀리면 작은 모델이 싼 만큼 잘못된 자동화도 많이 실행된다. 브라우저 자동화와 데스크톱 자동화를 같은 권한으로 묶으면 사고 범위가 커진다. 캐시와 배치를 비용 절감으로만 보고, 오래된 지식이나 잘못된 컨텍스트를 반복 재사용하면 품질이 떨어진다.
FAQ
Haiku 5.5가 싸졌다면 Sonnet이나 Opus를 줄여도 될까
줄일 수 있는 부분은 있다. 다만 최종 판단 모델을 통째로 바꾸기보다, 분류·추출·라우팅·중복 제거 같은 앞단 작업부터 바꾸는 편이 안전하다.
browser use와 computer use 중 무엇을 먼저 봐야 하나
웹페이지 안에서 끝나는 일이라면 browser use부터 보는 것이 낫다. 페이지 구조와 요소를 읽을 수 있어 좌표만 보는 방식보다 범위가 좁다. 데스크톱 앱이나 여러 앱을 오가는 작업이면 computer use가 필요하다.
작은 모델을 쓰면 보안 위험도 작아지나
그렇지 않다. 모델이 작아도 파일을 읽고, 버튼을 누르고, 외부로 전송할 권한이 있으면 위험은 그대로다. 보안은 모델 크기보다 권한·샌드박스·승인 지점으로 줄인다.
오늘 당장 측정할 지표는 무엇인가
요청 유형별 호출 수, 승격 비율, 잘못 라우팅된 요청, 사람 승인으로 되돌아온 비율, 캐시 재사용률, 도구 실행 실패율을 먼저 본다. 가격표보다 이 지표가 있어야 모델 교체의 효과를 판단할 수 있다.