좋은 AI 에이전트는 모델보다 구조가 먼저다
Google AI Agents Challenge 상위 제출작에서 반복된 네 가지 패턴을 개발자 눈높이로 풀었다. bidirectional MCP, event-driven concurrency, same-bar fallback, tiered routing을 작은 서비스에 어떻게 적용할지 정리한다.
결론부터
요즘 에이전트 이야기는 대부분 모델 이름에서 시작한다. 어떤 모델이 더 똑똑한지, 어떤 코딩 벤치마크를 이겼는지, 컨텍스트가 얼마나 길어졌는지. 물론 중요하다. 그런데 실제로 서비스를 만들다 보면 더 자주 터지는 문제는 따로 있다.
모델은 충분히 똑똑한데, 일의 흐름이 허술해서 실패한다.
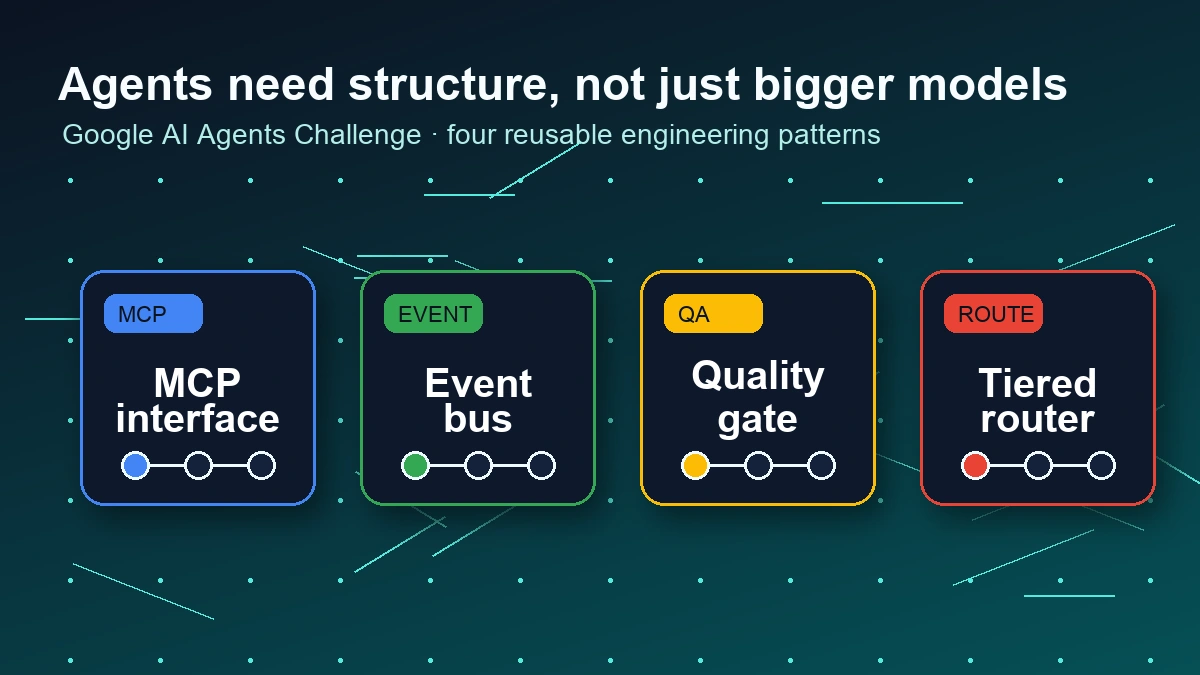
Google Developers Blog가 2026년 9월 2일 공개한 글은 이 지점을 꽤 잘 찌른다. Google for Startups AI Agents Challenge의 상위 제출작을 돌아보니, 잘 만든 에이전트들은 “최신 모델을 붙였다”보다 “일을 나누고, 연결하고, 실패를 처리하는 구조”가 닮아 있었다는 것이다. 반복된 패턴은 네 가지였다.
- Bidirectional MCP: 에이전트가 MCP 도구를 쓰는 데서 끝나지 않고, 자기 기능도 다른 에이전트가 부를 수 있는 MCP 서버로 노출한다.
- Event-driven concurrency: 앞 단계가 끝나면 다음 단계를 부르는 긴 체인 대신, 같은 이벤트를 여러 에이전트가 병렬로 받아 처리한다.
- Same-bar fallback: 작은 모델이나 예비 모델로 fallback 하더라도 품질 기준은 낮추지 않는다.
- Tiered routing: 비싼 모델을 부르기 전에 deterministic check, 캐시, 룰, 작은 모델로 먼저 걸러낸다.
이 네 가지를 읽으며 든 생각은 단순했다. “좋은 에이전트”는 챗봇이 아니라 작은 백엔드 시스템에 가깝다. 입력이 들어오고, 라우터가 판단하고, 도구가 데이터를 좁혀 가져오고, 이벤트가 흘러가고, 검증 게이트가 마지막 결정을 막는다. 모델은 그 안의 한 부품이다. 엔진은 강력하지만, 브레이크와 변속기와 계기판 없이 차를 몰 수는 없다.
이 글은 Google 글의 패턴 이름을 그대로 소개하는 글이 아니다. 각 패턴을 작은 제품, 사내 자동화, 블로그 파이프라인, 코딩 에이전트 운영에 바로 가져갈 수 있는 설계 언어로 번역해본다.
패턴 1. Bidirectional MCP: 도구를 쓰는 에이전트에서, 도구가 되는 에이전트로
MCP(Model Context Protocol)는 AI 애플리케이션과 외부 시스템을 연결하는 공개 표준이다. 공식 설명은 “AI 앱을 데이터 소스, 도구, 워크플로에 연결하는 방식”이다. 흔한 예시는 이렇다. Claude나 ChatGPT 같은 클라이언트가 MCP 서버를 통해 파일, DB, 캘린더, 검색, 내부 API를 호출한다.
처음 MCP를 붙이면 자연스럽게 한 방향만 떠올린다.
에이전트 → MCP 서버 → DB / API / 파일이것만 해도 좋다. 모델에게 원본 DB를 통째로 붙이는 대신, “이번 작업에 필요한 작은 답”만 도구로 가져올 수 있기 때문이다. 예를 들어 성능 분석 에이전트가 있다면 전체 telemetry table을 프롬프트에 붙이는 대신, get_slow_job_trace(job_id) 같은 도구로 특정 작업의 실행 계획과 stack trace만 가져오게 만들 수 있다. 토큰도 줄고, 보안 사고 면도 줄어든다.
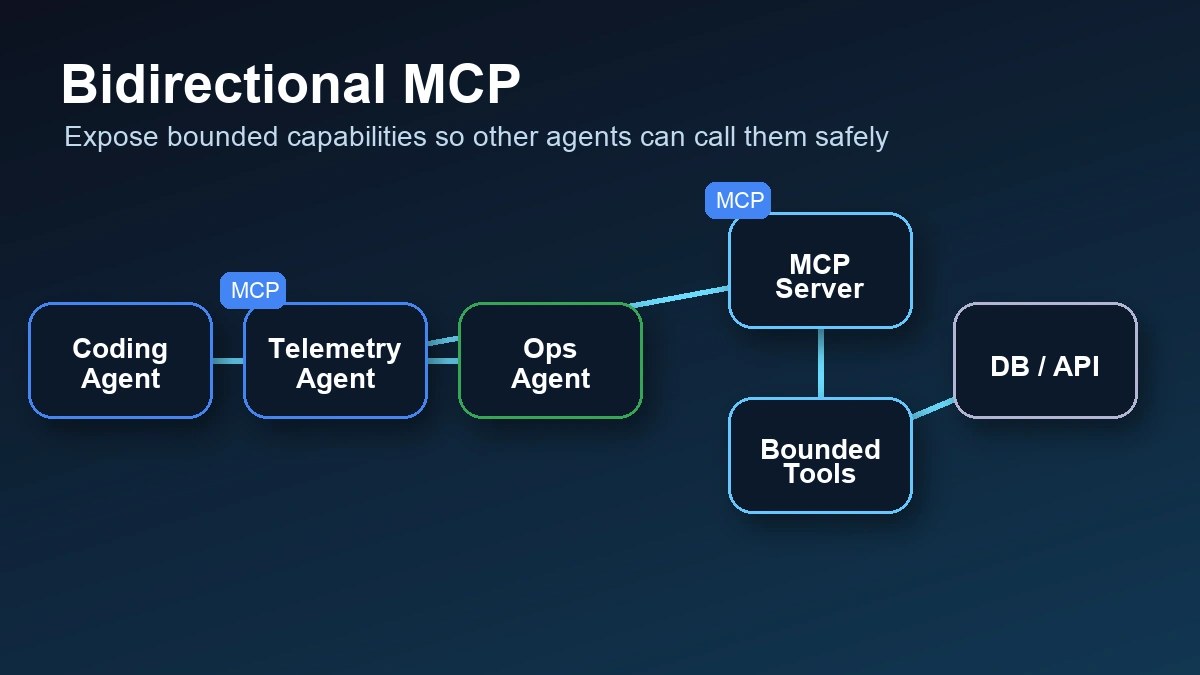
Google 글에서 흥미로운 지점은 그다음이다. 상위 제출작 중 일부는 에이전트가 MCP 클라이언트이면서 동시에 MCP 서버가 됐다. 즉 다른 에이전트가 그 에이전트의 판단 기능을 도구처럼 호출할 수 있게 만든 것이다.
코딩 에이전트 → 성능 분석 에이전트의 MCP 서버 → 성능 분석 에이전트 → 내부 telemetry 도구이 차이는 꽤 크다. 사람용 대시보드는 목적지다. 사람이 열고, 보고, 복사해서 다른 곳에 붙인다. 반면 MCP 서버가 된 에이전트는 인프라가 된다. 다른 에이전트가 자기 워크플로 안에서 바로 부를 수 있다.
작게 적용하면 이런 식이다.
| 지금 있는 기능 | MCP 서버로 바꾸면 좋은 형태 |
|---|---|
| 배포 로그를 읽고 원인 후보를 말해주는 스크립트 | diagnose_deploy_failure(run_id) |
| 블로그 후보를 랭킹하는 내부 자동화 | rank_blog_topics(date, exclusions) |
| PR diff를 보고 위험 파일을 찾는 리뷰 에이전트 | review_risk_summary(pr_number) |
| 고객 문의를 분류하는 봇 | classify_ticket(message, account_tier) |
핵심은 “모델을 외부에 노출하자”가 아니다. 입출력 경계를 좁힌 기능을 도구처럼 만들자다. raw SQL, 전체 로그, 전체 파일 시스템을 넘기면 위험하다. 대신 bounded answer를 반환하는 도구를 만들면 다른 에이전트가 불러도 훨씬 안전하다.
작은 체크리스트
- 이 에이전트가 잘하는 일을 한 문장 함수로 부를 수 있는가?
- 입력은
run_id,slug,ticket_id처럼 좁은 식별자인가? - 출력은 긴 자유문보다 JSON, verdict, score, next_action처럼 재사용 가능한 형태인가?
- 내부 DB나 파일 경로를 그대로 노출하지 않는가?
- 다른 에이전트가 실패해도 안전하게 retry하거나 무시할 수 있는가?
이 다섯 개에 답할 수 있으면, 그 기능은 챗봇 화면보다 MCP 도구가 더 잘 맞을 수 있다.
패턴 2. Event-driven concurrency: 긴 전화 게임을 끊기
많은 에이전트 자동화는 처음에 이렇게 생긴다.
수집 에이전트 → 요약 에이전트 → 검증 에이전트 → 발행 에이전트보기에는 깔끔하다. 하지만 실제로 돌려보면 문제가 생긴다. 앞 에이전트가 늦으면 뒤는 아무것도 못 한다. 중간 단계가 실패하면 전체 체인이 멈춘다. 각 단계가 다음 단계의 입력 포맷을 조금만 다르게 만들면, 마지막 단계에서 이상한 결과가 나온다. 회사에서 전화를 돌리다가 한 사람이 점심 먹으러 가면 전체 일이 멈추는 상황과 비슷하다.
Event-driven concurrency는 이 구조를 바꾼다. 한 단계가 다음 단계를 직접 부르는 대신, “이 일이 생겼다”는 이벤트를 발행한다. 관심 있는 에이전트들이 같은 이벤트를 받아 각자 움직인다.
ARTICLE_DRAFT_READY
  ├─ 사실 검증 에이전트
  ├─ 문체 검수 에이전트
  ├─ SEO/GEO 검수 에이전트
  └─ 이미지 검수 에이전트
여기서 좋은 점은 두 가지다.
첫째, 시간이 덜 더해진다. 순차 체인은 A 시간 + B 시간 + C 시간이 된다. 이벤트 기반 병렬 처리는 오래 걸리는 작업 몇 개가 동시에 돈다. 사람이 기다리는 시간은 대체로 가장 느린 작업 하나에 가까워진다.
둘째, 책임이 선명해진다. 사실 검증 에이전트는 사실만 본다. 문체 검수 에이전트는 문장과 독자 경험만 본다. SEO/GEO 에이전트는 정의문, FAQ, 인용 가능성을 본다. 하나의 거대한 “검수 프롬프트”가 모든 것을 대충 보는 것보다 낫다.
내 블로그 파이프라인도 이 구조에 가깝다. 후보 수집, 랭킹, 초안, 사실 검증, 문체 검수, GEO 검수, 빌드, 미리보기 업로드가 하나의 긴 프롬프트로 뭉치면 어디서 틀렸는지 모른다. 반대로 이벤트와 게이트로 나누면 “초안은 통과, 사실 검증은 보류, 빌드는 실패”처럼 상태를 볼 수 있다.
작게 시작하는 법
처음부터 Kafka나 Pub/Sub를 붙일 필요는 없다. 작은 자동화라면 파일 하나, SQLite table 하나, GitHub issue label 하나도 이벤트가 될 수 있다.
{
  "event": "DRAFT_READY",
  "slug": "agent-structure-patterns",
  "draft_path": "src/content/blog/agent-structure-patterns.md",
  "required_checks": ["facts", "style", "geo", "build"]
}
중요한 건 “다음 함수를 직접 호출할지”보다 “상태가 바뀌었음을 기록하고, 각 작업자가 그 상태를 읽게 할지”다. 작은 팀에서는 이 차이만으로도 디버깅 난이도가 확 내려간다.
패턴 3. Same-bar fallback: fallback은 품질 할인권이 아니다
모델 fallback은 유혹적이다. 비싼 모델이 느리거나 실패하면 작은 모델로 보내면 된다. API 장애가 나면 다른 provider로 보내면 된다. 비용도 줄고 안정성도 올라간다. 여기까지만 들으면 아주 좋은 기능처럼 보인다.
문제는 fallback이 조용히 품질 기준을 낮출 때다.
예를 들어 보안 검수 작업을 생각해보자. 원래는 강한 모델에게 맡겼는데 rate limit 때문에 작은 모델로 fallback 했다. 작은 모델이 “문제 없음”이라고 답했다. 이때 정말 통과시켜도 될까? 답은 대부분 아니오다. fallback 모델은 일을 대신할 수 있지만, 통과 기준까지 대신 낮춰서는 안 된다.
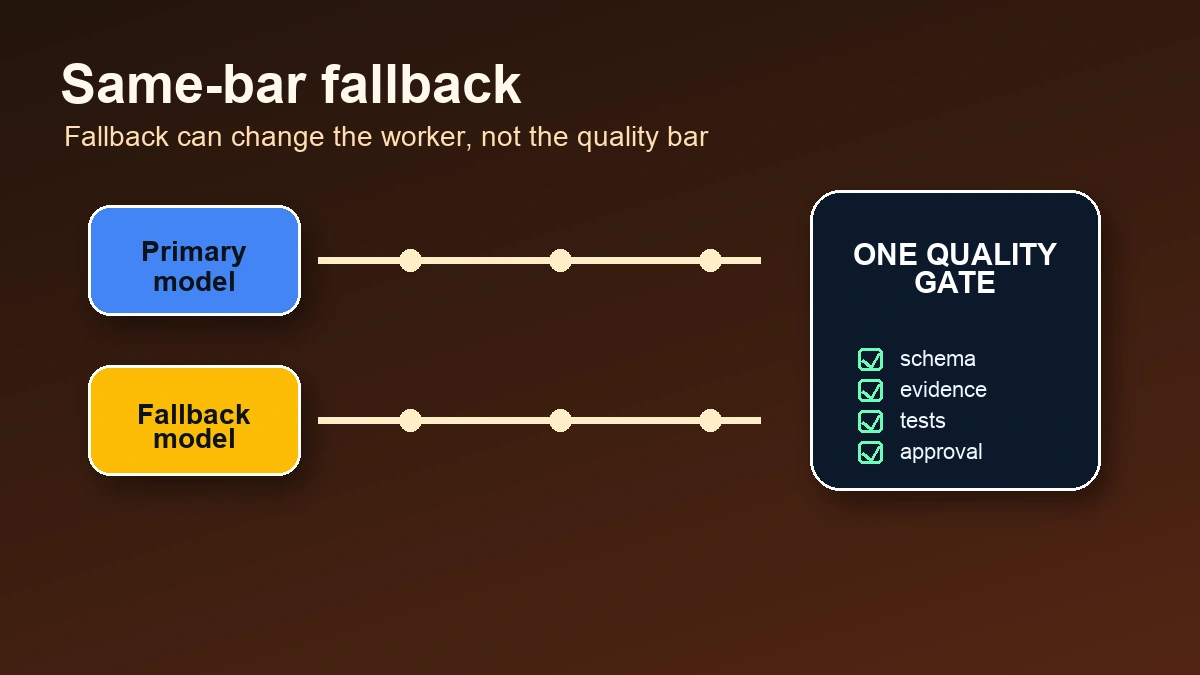
Google 글의 “same-bar fallback”은 이 점을 강조한다. 예비 모델이 나와도 같은 bar를 넘어야 한다. 같은 스키마를 채워야 하고, 같은 증거를 제시해야 하며, 같은 테스트를 통과해야 한다.
실무에서는 이렇게 설계하는 편이 안전하다.
| 작업 | fallback 허용 | fallback 통과 조건 |
|---|---|---|
| 단순 분류 | 예 | confidence와 근거 필드가 기준 이상 |
| 요약 초안 | 예 | 사람이 볼 초안으로만 저장, 자동 발행 금지 |
| 코드 리팩터링 | 조건부 | 테스트 통과 + diff review 필요 |
| 보안/결제/권한 변경 | 매우 제한 | fallback PASS 금지, escalated review |
| 외부 상태 변경 | 조건부 | dry-run 후 read-back 검증 필수 |
여기서 포인트는 fallback 자체를 막는 게 아니다. 작은 모델은 충분히 쓸모 있다. 다만 작은 모델이 냈다는 이유로 검증을 생략하면 안 된다. 특히 “PASS”, “배포 가능”, “삭제해도 됨”, “권한 부여 가능” 같은 단어는 모델 이름보다 증거 계약이 먼저다.
내 자동화에도 그대로 적용된다. 초안 생성은 fallback 가능하다. 이미지 설명도 fallback 가능하다. 하지만 발행은 fallback 결과만 보고 하면 안 된다. npm run build, npm run seo:geo:audit, 미리보기 read-back, Owner OK 같은 바깥 검증이 있어야 한다.
패턴 4. Tiered routing: 모델 호출 전에 먼저 할 수 있는 일을 하자
에이전트 비용을 줄이는 가장 좋은 방법은 싼 모델을 쓰는 것만이 아니다. 모델을 안 불러도 되는 일을 먼저 제거하는 것이다.
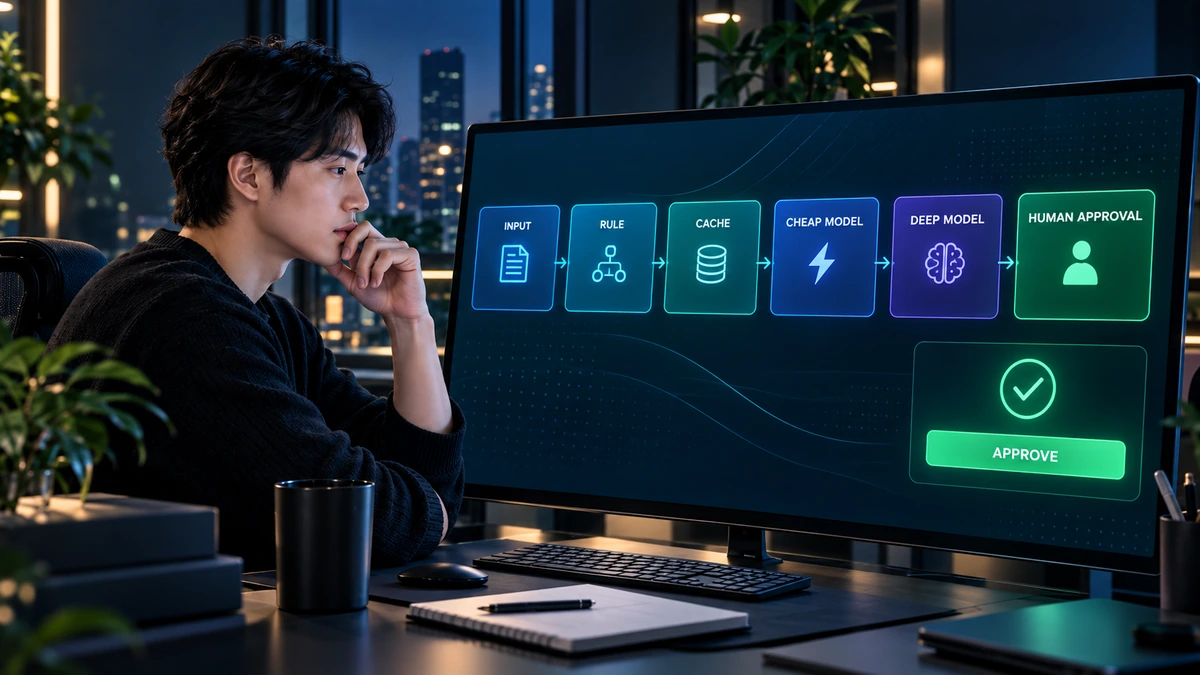
Tiered routing은 이 생각에서 출발한다. 모든 요청을 곧장 큰 모델로 보내는 대신, 앞단에서 싸고 확실한 단계들을 통과시킨다.
입력
  → deterministic rule
  → cache / previous result
  → cheap model
  → expensive model
  → human approval
예를 들어 블로그 후보 추천을 만든다고 해보자. 굳이 처음부터 큰 모델이 모든 뉴스를 읽을 필요는 없다.
- 이미 쓴 slug와 제외 주제를 코드로 제거한다.
- 공식 출처와 날짜가 없는 후보를 룰로 낮춘다.
- 키워드 중복도를 계산한다.
- 작은 모델로 후보를 10개에서 5개로 줄인다.
- 마지막에 큰 모델이 gap과 차별화를 정리한다.
이렇게 하면 모델 호출 비용만 줄어드는 게 아니다. 결과도 더 안정된다. deterministic rule은 흔들리지 않는다. 이미 쓴 글과 겹치면 언제나 제거한다. 날짜가 오래됐으면 감점한다. 공식 출처가 없으면 보류한다. 모델은 “판단이 필요한 마지막 부분”에 집중한다.
작은 서비스에서도 똑같다.
| 요청 | 먼저 할 deterministic check | 모델이 맡을 일 |
|---|---|---|
| 고객 문의 분류 | 계정 상태, 상품명, 금칙어, 언어 감지 | 애매한 의도 해석 |
| PR 리뷰 | 변경 파일, 테스트 유무, secret 패턴 | 리스크 설명과 우선순위 |
| 장애 원인 분석 | 최근 배포, 에러율, 로그 키워드 | 원인 후보 묶기 |
| 문서 검색 에이전트 | 정확한 제목/ID 검색, 캐시 | 관련 문맥 요약 |
| 블로그 초안 | 중복 slug, frontmatter schema | 읽히는 구조와 비유 |
Tiered routing을 잘 만들면 에이전트가 더 “똑똑해진” 것처럼 보인다. 사실은 모델이 더 똑똑해진 게 아니라, 모델에게 덜 어지러운 책상을 준 것이다.
네 패턴을 하나로 묶으면: 에이전트는 파이프라인이다
네 가지 패턴은 따로 떨어져 보이지만, 실제로는 한 문장으로 묶인다.
에이전트를 사람처럼 말 잘하는 박스로 보지 말고, 입력·도구·이벤트·검증·라우팅이 있는 파이프라인으로 보자.
이 관점으로 보면 설계 질문이 달라진다.
- 어떤 모델을 쓸까? → 어떤 작업은 모델 없이 끝낼 수 있을까?
- 어떤 프롬프트를 쓸까? → 어떤 입력과 출력 계약을 고정할까?
- 어떤 도구를 붙일까? → 이 기능은 다른 에이전트가 다시 호출할 수 있을까?
- 실패하면 어떻게 다시 물어볼까? → 실패 상태를 어떻게 기록하고 누가 재시도할까?
- 작은 모델로 바꿀까? → 작은 모델도 같은 품질 게이트를 통과하게 만들었나?
이 질문들이 훨씬 실무적이다. “에이전트가 똑똑해질 것”이라는 말보다 “이 작업은 deterministic check로 먼저 제거하고, 남은 것만 모델로 보낸다”가 더 바로 적용된다.
오늘 적용할 1가지
거창하게 새 프레임워크를 도입하지 않아도 된다. 오늘 하나만 한다면, 기존 에이전트 작업 하나를 골라서 아래 표를 채워보면 된다.
| 항목 | 답 |
|---|---|
| 이 작업의 입력은 무엇인가? | 예: PR 번호, Slack 메시지, 배포 run ID |
| 모델 전에 제거할 수 있는 룰은? | 예: 파일 경로, 날짜, 상태 코드, schema validation |
| 외부 도구는 어떤 bounded answer를 줘야 하나? | 예: 전체 로그가 아니라 최근 에러 20줄 |
| fallback 시에도 유지할 품질 기준은? | 예: 근거 2개 미만이면 PASS 금지 |
| 사람이 승인해야 하는 마지막 단계는? | 예: 배포, 삭제, 권한 변경, 발행 |
이 표가 비어 있으면 프롬프트를 더 깎기 전에 구조부터 봐야 한다. 프롬프트는 문장이고, 구조는 안전벨트다.
내 파이프라인에 남길 점
이번 글을 쓰면서 블로그 자동화에도 몇 가지 개선 포인트가 선명해졌다.
첫째, 후보 수집과 랭킹을 더 분리해야 한다. 지금은 “뉴스를 보고 후보를 만든다”가 한 덩어리처럼 보일 때가 있다. 앞으로는 source_seen, candidate_created, duplicate_filtered, gap_scored, owner_selected 같은 상태를 나눠두면 좋다.
둘째, fact check는 same-bar fallback 원칙을 가져가야 한다. 검색 도구가 일시적으로 실패하거나 추출이 일부만 됐을 때, 그 상태로 “검증 완료”라고 말하면 안 된다. 공식 출처를 못 읽었으면 못 읽었다고 표시하고, 다른 경로로 재시도하거나 보류해야 한다.
셋째, 이미지도 routing 대상이다. 매번 같은 photoreal 책상 컷으로 가는 게 아니라, 주제에 따라 편집 그래픽, 회로 보드, 제품 로고 맥락 요소, 코드 카드, 아이소메트릭 구조도로 라우팅해야 한다. 다만 AI의 편의성은 결국 사람이 체감하는 것이므로, 사람이 자동화 결과를 검토하거나 승인하는 장면처럼 내용과 직접 연결되는 위치에는 인물 이미지도 섞는 편이 좋다. 이번 글은 그래서 Google/ADK/MCP 느낌의 고대비 구조 카드와, 마지막 승인 단계에 사람이 들어가는 운영 보드를 함께 썼다.
넷째, 미리보기와 발행은 계속 분리한다. 초안은 noindex:true로 만들고, 빌드와 감사와 read-back을 확인한 다음, Owner OK가 있어야만 발행한다. 에이전트 글을 쓰면서 다시 확인한 원칙이다. 모델이 자신 있게 말해도 외부 상태는 읽어봐야 한다.
FAQ
MCP는 꼭 써야 하나?
꼭 그렇지는 않다. 내부 자동화 하나라면 HTTP API, CLI, 함수 호출, 큐만으로도 충분하다. 다만 여러 에이전트나 여러 클라이언트가 같은 기능을 재사용해야 한다면 MCP가 좋은 표준 인터페이스가 될 수 있다. 특히 “이 도구를 Claude, ChatGPT, IDE, 사내 에이전트가 모두 비슷하게 부르게 하고 싶다”면 검토할 만하다.
Event-driven 구조는 너무 복잡하지 않나?
처음부터 메시지 브로커를 붙이면 복잡하다. 하지만 이벤트라는 생각 자체는 작게 시작할 수 있다. draft_ready.json 파일 하나, DB row status 하나, GitHub label 하나도 이벤트 역할을 할 수 있다. 중요한 건 다음 작업을 직접 호출하는 긴 체인에서 벗어나 상태를 기록하는 것이다.
fallback 모델을 쓰면 안 된다는 뜻인가?
아니다. fallback은 유용하다. 장애 대응과 비용 절감에 꼭 필요할 때가 많다. 다만 fallback이 품질 기준을 낮추는 통로가 되면 안 된다. 작은 모델이 답했더라도 schema, evidence, test, human approval 같은 바깥 기준은 그대로 둬야 한다.
Tiered routing은 모델 라우팅과 같은 말인가?
겹치지만 더 넓다. 모델 A와 모델 B 중 무엇을 고르는 것도 routing이다. 하지만 tiered routing은 모델 호출 전의 deterministic rule, 캐시, DB 조회, 정규식 검사까지 포함한다. 가장 싼 단계는 작은 모델이 아니라 코드 한 줄일 때가 많다.
좋은 에이전트의 첫 설계 문서는 무엇부터 쓰면 좋나?
프롬프트보다 IO 계약을 먼저 쓰는 편이 좋다. 입력, 허용 도구, 금지 행동, 출력 schema, 실패 상태, 승인 조건을 한 페이지로 정리한다. 그다음 프롬프트를 쓰면 모델이 해야 할 일이 훨씬 좁아진다.
출처와 기준시점
기준시점: 2026-09-10 07:00 KST.
- Google Developers Blog, “4 engineering patterns behind the strongest AI Agents Challenge submissions”, 2026-09-02. https://developers.googleblog.com/4-engineering-patterns-behind-the-strongest-ai-agents-challenge-submissions/
- Model Context Protocol 공식 소개 문서, “What is the Model Context Protocol (MCP)?” https://modelcontextprotocol.io/docs/getting-started/intro
- Google Agent Development Kit 공식 사이트. https://adk.dev/
- Google agents-cli GitHub 저장소. https://github.com/google/agents-cli